Wanneer we met elkaar communiceren, putten we onbewust uit eerdere ervaringen met taal. Terwijl we beginnen te spreken, lopen onze hersenen al een stap vooruit en sturen ze ons naar begrijpelijke woorden en zinnen.
ChatGPT en andere grote taalmodellen werken volgens een vergelijkbaar principe. Ze verwerken de woorden die er al staan en voorspellen welk woord waarschijnlijk volgt. Zo bouwen ze stap voor stap een samenhangende zin.
Als je als muzikant ooit bladmuziek hebt gelezen, ken je dat voortdurende schakelen tussen wat al klonk en wat hierna komt. Wie goed van blad wil spelen, leest altijd iets vooruit op wat die op dat moment speelt of zingt. Terwijl we lezen, verwerken onze hersenen wat eraan voorafging, sturen ze ons lichaam aan en springen ze alweer vooruit naar de noten die nog moeten komen.
Maar wat doet het taalmodel eigenlijk? Pakt het gewoon een willekeurig woord uit een grote hoop woorden en vult het automatisch aan? Niet echt. Ik gebruik muziek als metafoor om uit te leggen wat er gebeurt.
Stel je twee muzikanten voor die in een kamer zitten en voor het eerst naar dezelfde bladmuziek kijken. De ene muzikant is een AI, de andere een mens. Wat zien ze?
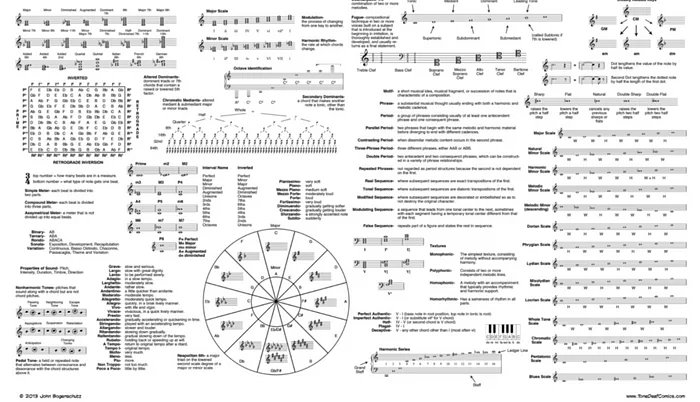
De menselijke muzikant kijkt naar de sleutel, maatsoort, toonsoort, het tempo en de aanwijzingen voor expressie. Dan zijn er de noten zelf. Iedere noot heeft een harmonische waarde, weergegeven door haar plaats op de notenbalk, en een ritmische waarde, weergegeven door de manier waarop zij is geschreven. Wij mensen lezen die noten van links naar rechts, regel voor regel en van boven naar beneden. Ondertussen sturen onze hersenen onze vingers, mond, lippen of stembanden in de richting die op de bladmuziek staat aangegeven.
Een AI-model leest totaal anders. De manier waarop het al deze informatie verwerkt, voelt bijna buitenaards: het verwerkt de context en de noten niet netjes één voor één, maar legt in één keer verbanden tussen alle onderdelen.
Vervolgens deelt het model de informatie op in kleinere segmenten en groepeert het elementen die statistisch op elkaar lijken. Van daaruit zoekt het naar patronen in die kleine muziekblokken. De ritmische en harmonische eigenschappen van iedere noot worden als getallen weergegeven. Terzijde: jazzmusici doen iets vergelijkbaars wanneer ze naar relatieve in plaats van letterlijke harmonie kijken. Daarna berekent het model welke noten in deze context het belangrijkst zijn. Het kijkt onder meer naar onderlinge afstanden, terugkerende verhoudingen en patronen. Zo kan het bepalen welke noten in de compositie de meeste aandacht verdienen.
(Dit is een vereenvoudigde metafoor: het model verwerkt de verbanden in samenhang, niet zoals een mens noot voor noot leest.)
Daarna wordt het proces nog minder menselijk. Het model brengt al die correlaties samen in compacte reeksen getallen en koppelt die weer aan afzonderlijke noten. Een heel spectrum aan context en statistische relaties wordt samengeperst tot iets wat voor een mens nauwelijks voorstelbaar is: een embedding.
Omdat het model de informatie in samenhang heeft verwerkt en embeddings aan de verschillende onderdelen heeft gekoppeld, kan het bij een gewijzigde noot of een verzoek om nieuw materiaal razendsnel relaties binnen het hele muziekstuk meewegen. Zo kan het een samenhangend vervolg voorstellen of een wijziging door de hele compositie heen verwerken zonder direct de draad kwijt te raken.
Dankzij het taalmodel is de muziek op een bijzonder compacte manier onderling verbonden en verweven geraakt.
Dat is de letterlijke kant van het verhaal. Zowel bij de menselijke als bij de AI-muzikant is er ook informatie aanwezig die niet expliciet op de bladmuziek staat:
Wanneer wij mensen muziek lezen, beschikken we over een catalogus van geoefende toonladders en akkoorden. Dat is een raster van tonale informatie waarin de muziek past als consonantie, of waarvan ze zich dissonant verwijdert. Daarnaast hebben we culturele context. We weten eenvoudigweg waarom Mozart Europees klinkt en Antonio Carlos Jobim Braziliaans. Onze hersenen raadplegen tijdens het lezen en uitvoeren van dit muziekstuk een bibliotheek met contextuele informatie die niet direct aan het stuk is gekoppeld. Daardoor begrijpen we beter wat er op de pagina staat.
Een AI-model beschikt op zijn beurt over een enorme hoeveelheid trainingsmateriaal. Het proces dat ik hierboven beschreef, bepalen welke informatie in een bepaalde context aandacht verdient, wordt doorgaans krachtiger naarmate het model op meer en gevarieerder materiaal is getraind. De AI-muzikant uit deze metafoor kan daardoor verbanden leggen op een schaal die voor één mens onhaalbaar is.
Het verbazingwekkendste aan deze snel ontwikkelende technologie is dat een model door een doolhof van data kan navigeren. Het berekent tussen een ontzagwekkende hoeveelheid mogelijke verbanden welke informatie of welk woord waarschijnlijk relevant is, en doet dat op een nauwelijks voorstelbare schaal en snelheid.
Op twee cruciale aspecten na:
Efficiëntie en beoordelingsvermogen
Efficiëntie: de hoeveelheid energie die de AI nodig heeft voor iets simpels als het lezen en uitvoeren van “Twinkle, Twinkle, Little Star” is ronduit absurd.
En dan het beoordelingsvermogen: goed nieuws voor Team Mens. Wij kunnen misschien niet in precies tien seconden een script van Breaking Bad herschrijven en Walt als Homer Simpson laten praten, maar we kunnen iets veel mooiers.
We kunnen zeggen: “Nee, dat is zinloze tijdverspilling. Ik ga in plaats daarvan iets nuttigs doen”, zoals muziek maken. En we weten precies waarom.
Bedankt voor het lezen,
Kai