Wie zegt dat dit een interessante tijd is om met technologie te werken en je erin te verdiepen, drukt zich nog zacht uit. We lijken steeds verder verstrikt te raken in een spiraal van innovatie en investeringen, waarbij de ‘wow’-momenten inmiddels bijna wekelijks voorbijkomen. Als ik iets cynischer was, zou ik zeggen dat dit meer te maken heeft met de industrie die rond innovatie is ontstaan. Maar de logica achter dat cynisme heeft ongeveer evenveel houvast als herfstbladeren op een winderige dag.
Laten we dus eens proberen gas terug te nemen, even stil te staan en de nieuwste technologieën te bekijken in het licht van meer dan 80 jaar wiskunde, informatica en techniek. Dit korte (oké, relatief korte) artikel gaat over een man, een katalysator en een concept dat veel verder reikte dan technologie. Cybernetica beïnvloedde de neurowetenschap en de filosofie, en vond later ook haar weg naar het ecologische denken. Ze droeg ook bij aan een andere kijk op de relatie tussen mensen en machines.
Laten we beginnen bij de persoon. Norbert Wiener werd in 1894 geboren. Hij was een wonderkind en kreeg grotendeels thuis les van zijn vader voordat hij naar de middelbare school ging. Als schooljongen schreef hij al een essay met de titel The Theory of Ignorance, waarin hij de grenzen van de menselijke kennis onderzocht. Op de respectabele leeftijd van 14 jaar had hij zijn bachelor wiskunde aan Tufts binnen. Hij begon vervolgens aan een studie zoölogie aan Harvard, sloeg een andere richting in met filosofie aan Cornell en keerde daarna terug naar Harvard. In 1913 promoveerde hij daar op 18-jarige leeftijd in de filosofie, met een proefschrift over wiskundige logica.
Zijn academische prestaties zo opsommen lijkt misschien wat omslachtig voor een kort essay over AI, maar verderop wordt duidelijk waarom ze ertoe doen. (Zijn combinatie van wiskunde, filosofie en belangstelling voor levende systemen sluit rechtstreeks aan op de grondslagen van AI en de richting die we opgaan — denk ik.) Wiener was een genie en stelde met gemak vragen die de grenzen tussen vakgebieden overschreden. Het probleem dat hij uiteindelijk zou aanpakken, liet zich ook niet netjes binnen één vakgebied houden.
In het begin van zijn loopbaan hopte hij van universiteit naar universiteit en van de ene baan naar de andere. Hij had een leerplek in de techniek, schreef voor een encyclopedie en werkte tijdens de Eerste Wereldoorlog aan artillerieberekeningen. Maar in 1919 kwam hij bij MIT terecht, waar hij de rest van zijn loopbaan bleef. Hij was al een gevestigd wiskundige toen de Tweede Wereldoorlog uitbrak. De oorlog opende een nieuw hoofdstuk in zijn werk.
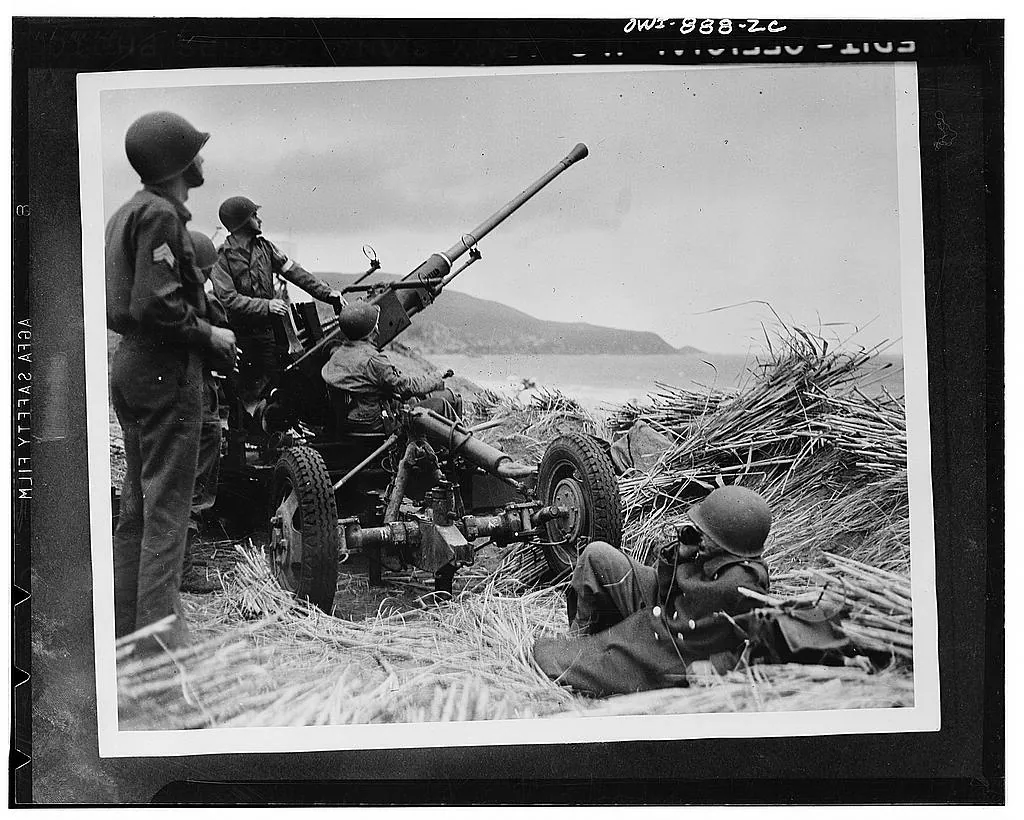
Dat hoofdstuk begon in een van de donkerste periodes uit de wereldgeschiedenis. In 1940, toen Groot-Brittannië vanuit de lucht werd aangevallen, bood Wiener zijn diensten aan voor het Amerikaanse oorlogsonderzoek. Samen met ingenieur Julian Bigelow onderzocht hij een voorspellingssysteem voor luchtafweergeschut: een systeem dat op basis van de recente bewegingen van een vliegtuig kon schatten waar het zich zou bevinden wanneer een granaat daar aankwam. Voor dit militaire vraagstuk moesten het gedrag van een mens en de beweging van een machine in één berekening worden samengebracht.
In gewone mensentaal komt het hierop neer.
Een snel vliegend vliegtuig vanaf de grond met een kanon neerschieten is ontzettend moeilijk. Zelfs als een motor helpt om het kanon te richten, verstrijkt er tijd tussen het zien van het doelwit, het richten en het moment waarop de granaat op de juiste plek aankomt. Als je het probleem in kleinere onderdelen opdeelt, lijken de uitdagingen al gauw bijna onoverkomelijk.
Laten we de mechanische problemen even overslaan en op deze vragen inzoomen:
- Is dat eigenlijk wel een vliegtuig waarop je schiet? Eerst moet je een vliegtuig opmerken en vervolgens vaststellen of het een doelwit is. Radar hielp om vliegtuigen te lokaliseren en te volgen, maar met een vlek op een radarscherm was je er nog niet. Daaruit alleen kon je niet afleiden of een vliegtuig bevriend of vijandelijk was. Om dat vast te stellen was ook andere informatie nodig, onder meer van de Identification Friend or Foe-apparatuur die tijdens de oorlog werd gebruikt. Detectie, identificatie en voorspelling waren afzonderlijke taken, waarvan de nauwkeurigheid bovendien te betwijfelen viel.
- Wat doen piloten als je op ze schiet? Aan welke kant van de oorlog ze ook staan, piloten zijn behoorlijk gemotiveerd om niet te worden neergeschoten. Ze kunnen draaien, stijgen, dalen of van snelheid veranderen. Wat het vliegtuig fysiek aankan, beperkt hun mogelijkheden, maar de schutter kan niet vooraf weten wat de volgende manoeuvre wordt.
- Waar is het vliegtuig wanneer de granaat daar aankomt? Ook als je het doelwit eenmaal hebt geïdentificeerd, ben je al te laat als je richt op de plek waar je het ziet. Je hebt een voorspelling nodig op basis van de recente bewegingen van het vliegtuig en het gedrag van de persoon aan de stuurknuppel.
Hier kwamen Wieners belangstelling voor wiskunde en zijn interesse in gedrag samen. Hij en Bigelow beschouwden de piloot en het vliegtuig als een gekoppeld systeem dat een lus vormde. De piloot kreeg informatie over de beweging van het vliegtuig, bediende de besturing en kreeg nieuwe informatie over het resultaat. Tegelijkertijd hadden de schutter en het richtapparaat hun eigen vertragingen en correcties. Beide kanten reageerden op een situatie die voortdurend veranderde.
Maar welke informatie zou de schutter nu echt helpen? Wiener maakte deel uit van een breder netwerk van mensen die grip probeerden te krijgen op informatie, rekenprocessen en zenuwstelsels. Claude Shannon, Warren McCulloch en Walter Pitts horen ook bij dat verhaal. Hun werk raakte elkaar op belangrijke punten. Het loont om hier even bij stil te staan, want het woord informatie kan verrassend lastig te vangen zijn.
Shannon onderzocht hoe je berichten kunt weergeven en betrouwbaar kunt overbrengen. Zijn informatietheorie bood een wiskundige maat voor onzekerheid, niet voor de betekenis of het nut van een bericht. Voorspelbare herhaling kon compacter worden weergegeven. Met verliesvrije compressie kon een bericht minder opslagruimte innemen, terwijl de inhoud volledig terug te halen bleef.
Een korte formule helpt:
I(x) = -log2 P(x)
Hier is P(x) de kans die aan een gebeurtenis wordt toegekend voordat die plaatsvindt, en I(x) de statistische ‘verrassing’ ervan, gemeten in bits. Een gebeurtenis met een toegekende kans van een half levert één bit op; bij een kans van een achtste zijn dat er drie. Binnen dat kansmodel leveren onverwachte gebeurtenissen dus meer verrassing op. Dat maakt ze nog niet automatisch nuttiger.
Wiener had dezelfde intuïtie. In The Human Use of Human Beings schreef hij: ‘Hoe waarschijnlijker het bericht, hoe minder informatie het geeft.’9 Voor zijn voorspellingsprobleem had hij waarnemingen nodig die hielpen inschatten wat er vervolgens zou gebeuren. Een grotere berg gegevens bood geen garantie op een betere schatting. Shannon en Wiener werkten aan verschillende kanten van een verwant probleem; Shannon erkende expliciet Wieners invloed op zijn werk.8
Bij het vliegtuig ging het om de vraag hoe je waarnemingen uit het verleden omzet in een bruikbare schatting van de toekomst. Een vereenvoudigde versie van Wieners idee van lineaire voorspelling, gebaseerd op een eindige reeks eerdere waarnemingen, ziet er zo uit:10
x̂(t + h) = m∑j = 0aj x(t - jΔt)
Voordat je vanwege al die symbolen de pagina sluit: het idee is goed te volgen. Neem een reeks eerdere metingen, vermenigvuldig elke meting met een weegfactor en tel de uitkomsten bij elkaar op om een toekomstige waarde te schatten. Hier kan x staan voor één coördinaat van de positie van het vliegtuig. h geeft aan hoe ver vooruit we willen voorspellen, en de weegfactoren worden zo gekozen dat de gemiddelde kwadratische voorspellingsfout kleiner wordt. Sommige delen van het recente verleden zijn bruikbaarder dan andere. Een voorspelling kan de best beschikbare schatting zijn en er toch naast zitten.
Als sterk vereenvoudigd algoritme ziet dat er zo uit:
herhaal:
    lees de meest recente positie van het vliegtuig
    voeg die toe aan de gegevens over de recente bewegingen
    voorspel met die gegevens een toekomstige positie
    bereken de gewenste richting van het kanon
    meet de werkelijke richting van het kanon en stuur bij
    vergelijk latere waarnemingen met de eerdere voorspelling
Voor de duidelijkheid: dit is natuurlijk slechts een schets van de voorspellingslus waar Wiener mee te maken had. Nieuwe waarnemingen kunnen de volgende richtinstructie veranderen. Maar zodra een ongeleide granaat het kanon heeft verlaten, kan die geen nieuwe informatie of correctie meer ontvangen. De vertraging blijft, hoe slim de voorspelling ook wordt.
Wiener en Bigelow onderzochten hoe je het gedrag van mensen die een bewegend doel volgen statistisch kunt modelleren. Laboratoriumproeven wezen erop dat individuele proefpersonen herkenbare patronen konden vertonen (zoals onder stress naar rechts uitwijken), maar zo’n patroon bood geen zekerheid over de volgende manoeuvre. Een piloot kon beide kanten op draaien. Een schatting die het gemiddelde van die mogelijkheden nam, kon de granaat dus op een volstrekt onbruikbare plek laten belanden. De persoon wiens gedrag werd voorspeld, probeerde de uitkomst bovendien te vermijden en kon er bewust voor kiezen zich onvoorspelbaar te gedragen. Een lastig experiment, om het zacht uit te drukken.
Begin 1943 was het duidelijk: dit specifieke voorspellingssysteem had geen doorslaggevend praktisch voordeel boven eenvoudigere methoden laten zien. Het zou te gemakkelijk zijn om dat toe te schrijven aan de beperkte rekenkracht van de machines uit de jaren veertig of aan een gebrek aan gegevens om de taak uit te voeren. De beschikbare waarnemingen, hoe ver vooruit er voorspeld moest worden en de manoeuvreerruimte van het doelwit speelden allemaal een rol. Als wapenproject had het systeem teleurgesteld, maar de vragen die het opriep bleven nieuwe inzichten opleveren.
Het idee dat na dit mislukte experiment overeind bleef, was feedback: informatie over wat er gebeurt komt terug bij het systeem en verandert wat het vervolgens doet.
Een thermostaat is een alledaags voorbeeld. Je stelt de temperatuur in, een sensor meet hoe warm het in de kamer is en op basis van het verschil gaat de verwarming aan of uit. De verwarming verandert de kamertemperatuur, waardoor de volgende meting anders uitvalt en de verwarming daar weer op reageert. Zonder nieuwe metingen mist de thermostaat de informatie die nodig is om de temperatuur in de kamer te regelen. De cruisecontrol van een auto werkt volgens hetzelfde algemene principe: hij houdt de snelheid vast, ook als het wegverloop verandert.
We doen iets vergelijkbaars wanneer we een kopje willen pakken. We krijgen informatie over de beweging van onze hand en sturen die gaandeweg bij. Wiener en Bigelow bespraken met de fysioloog Arturo Rosenblueth de overeenkomsten tussen mechanische regeling en de werking van het zenuwstelsel. In hun artikel uit 1943, Behavior, Purpose and Teleology, gebruikten ze feedback om een belangrijke categorie doelgericht gedrag bij dieren en machines te analyseren.
Ik wil niet suggereren dat Wiener de feedbacklus heeft uitgevonden. Thermostaten en regelaars voor stoommachines bestonden al lang vóór zijn oorlogsonderzoek, en James Clerk Maxwell had in 1868 al een wiskundige analyse van regelaars gepubliceerd. Wiener en zijn medewerkers hielpen deze ideeën uit de techniek te verbinden met het denken over informatie, rekenprocessen en uiteindelijk AI zoals we die nu kennen.
Ondertussen ontwikkelde ook het onderzoek naar zenuwstelsels zich verder. In 1943 publiceerden McCulloch en Pitts een wiskundig model dat liet zien hoe netwerken van vereenvoudigde neuronen met drempelwaarden logische bewerkingen konden uitvoeren. Het legde mede de basis voor het onderzoek naar kunstmatige neurale netwerken. Hun model leerde niet zoals de neurale netwerken van vandaag dat doen. Na de oorlog kwamen deze onderzoekslijnen samen in bredere discussies, onder meer op de Macy-conferenties. Daar wisselden wetenschappers ook ideeën uit met onderzoekers uit de antropologie en psychologie.
In 1948 publiceerde Wiener zijn baanbrekende boek Cybernetics, met als ondertitel Control and Communication in the Animal and the Machine. Hij had de naam voor het vakgebied het jaar daarvoor gekozen, naar het Griekse kybernētēs, dat ‘stuurman’ betekent. Een passend beeld: wie stuurt, heeft een bestemming, houdt de koers in de gaten en stuurt onderweg bij.
En hier raakt dit verhaal aan de AI-vragen die mij bezighouden. Feedback kan een systeem helpen om zijn gedrag bij te sturen. Leren gaat verder: ervaring kan de regel veranderen die het systeem volgt. Bij recursieve zelfverbetering is de vraag of een systeem ook de methoden kan verbeteren waarmee het verdere verbeteringen tot stand brengt.
Dat onderscheid doet ertoe. Een thermostaat kan de temperatuur uitstekend bijsturen zonder ook maar iets te leren. Voordat we ons laten meeslepen door machines die zichzelf verbeteren, moeten we volgens mij begrijpen wat er verandert, wat als verbetering telt en wie dat mag bepalen. Bij het oorlogsvraagstuk was het doel betrekkelijk duidelijk, hoe moeilijk het ook was om het te bereiken. De doelen die we AI meegeven zijn vaak veel minder eenduidig.
Van feedbacklussen naar recursieve zelfverbetering
Het ‘cyber’ uit cybernetica is inmiddels helemaal ingeburgerd in het sciencefictionjargon van onze tijd. Cyberpunk, cyberspace, cyborgs en het onheilspellende Cyberdyne Systems. Het klinkt gewoon goed. Ik vraag me af wat Wiener ervan zou hebben gevonden dat zijn ideeën over feedback, besturing en de relatie tussen mens en machine hun weg naar de populaire cultuur hebben gevonden. Ik val daar net zo hard voor als ieder ander: de boeken van William Gibson heb ik keer op keer verslonden.
(Leuk weetje: Gibson heeft verteld dat hij het ‘cyber’ in cyberspace aan Wieners cybernetica ontleende.)
Maar hoe werkt zo’n feedbacklus nu precies, en waar gaat het volgens mij naartoe?
In de softwareontwikkeling is die feedbacklus al volop te zien. Softwareontwikkelaars schrijven prompts. Instructies, contextbestanden en een steeds grotere groep agents en subagents sturen de modellen aan. Ze geven werk aan elkaar door, op zoek naar betere antwoorden. Een agent kan een codebase bekijken, iets aanpassen, een test uitvoeren, de foutmelding lezen en het opnieuw proberen. Een mens kan ingrijpen, de opdracht verduidelijken of bepalen dat het resultaat goed genoeg is. Dat doet sterk denken aan de feedbacklus en de ‘stuurman’ waar het woord cybernetica naar verwijst.
Hoe komt het dat deze lus zo goed kan werken? Als we er met Wieners blik naar kijken, wordt één reden al snel duidelijk. Tools voor softwareontwikkeling zijn gemaakt om bijzonder bruikbare feedback te geven. Een compiler kan melden dat een naam niet bestaat. Een test kan laten zien dat de verwachte uitkomst zeven was, maar dat er zes uitkwam. Logbestanden kunnen vastleggen wat er voorafgaand aan een fout gebeurde. Daarmee heb je bij een volgende poging iets concreets om op voort te bouwen.
Al moet ik hier wel een beetje oppassen. Software kan probleemloos draaien en toch het verkeerde doen. Een test controleert alleen wat iemand erin heeft opgenomen, en een logbestand bevat alleen de gegevens die het systeem volgens zijn instellingen bijhoudt. De feedback kan dus heel veel informatie bevatten zonder volledig te zijn.
Dat onderscheid is belangrijk: hoe nuttig de lus is, hangt af van hoe goed de feedback aansluit op wat we werkelijk willen. Als ik een agent vraag een berekening te herstellen en een test meegeef die de relevante uitkomst controleert, heeft die agent een bruikbaar signaal om zich op te richten. Maar als de test een belangrijk geval over het hoofd ziet, kan elk nieuw succes mijn vertrouwen vergroten zonder dat de software beter klopt. Vaker herhalen lost een gebrekkige definitie van succes niet vanzelf op.
Achter dit alles zit nog een tweede lus, en die twee haal je gemakkelijk door elkaar. Voordat deze modellen aan een taak beginnen, zijn ze al getraind op grote verzamelingen code, tekst en ander materiaal. Tijdens die training passen optimalisatiemethoden de parameters van het model aan. In de aanvullende training daarna, de zogeheten post-training, kan het gedrag verder worden gevormd met voorbeelden en voorkeuren van mensen, door AI gegenereerde feedback of beloningen voor taken waarvan de uitkomst te controleren is. Programmeeropgaven met tests die je daadwerkelijk kunt uitvoeren, lenen zich daar bijzonder goed voor: sommige antwoorden zijn direct te controleren.
Maar de agent die mijn code repareert, gebruikt doorgaans de parameters die tijdens de training zijn bepaald, zonder die na elke foutmelding aan te passen. De volgende poging ziet er anders uit doordat de agent nieuwe informatie in zijn context heeft. Het model zelf kan de hele sessie ongewijzigd blijven. Een bewaarde instructie of een les die in een bestand is vastgelegd, kan ook een latere sessie beïnvloeden, maar alleen als die informatie dan weer wordt gebruikt.
We noemen dus nogal wat verschillende dingen ‘leren’: het project verbeteren, bruikbare context verzamelen, de tools van de agent aanpassen en het model opnieuw trainen. Die processen kunnen elkaar beïnvloeden, maar ze zijn niet hetzelfde. Voordat we zeggen dat een systeem zichzelf verbetert, moeten we weten wat er precies verandert.
En wat komt hierna?
Iedereen heeft het over RSI. Daar heb ik helaas zelf last van gehad, na een paar jaar contrabas spelen met een beroerde houding. Maar hier staat de afkorting voor iets anders:
Recursive self-improvement, oftewel recursieve zelfverbetering.
In de ambitieuze versie krijgt het AI-systeem zelf de taak om een groot deel van het proces dat ik heb geschetst te verbeteren. Het zou aanpassingen aan zijn tools kunnen voorstellen, zijn instructies herzien, experimenten ontwerpen of helpen een opvolgend model te ontwikkelen. Daar horen verschillende niveaus van zelfstandigheid bij. Een agent toestemming geven om een paar bestanden te bewerken is nog niet hetzelfde als het hele proces uit handen geven.
Het interessante is dat een beter systeem vervolgens óók beter zou kunnen worden in het vinden en doorvoeren van nieuwe verbeteringen. Het recursieve aspect dat mij interesseert, zit precies daarin: je verbetert het verbeterproces zelf, zodat een volgende ronde daarvan kan profiteren. De term wordt in de literatuur op verschillende manieren gebruikt. Maar dit onderscheid voorkomt dat we iedere nieuwe poging aanzien voor bewijs van intelligentie die zich steeds sneller ontwikkelt.
Deze twee diagrammen laten zien op welk punt in de lus die verandering plaatsvindt.
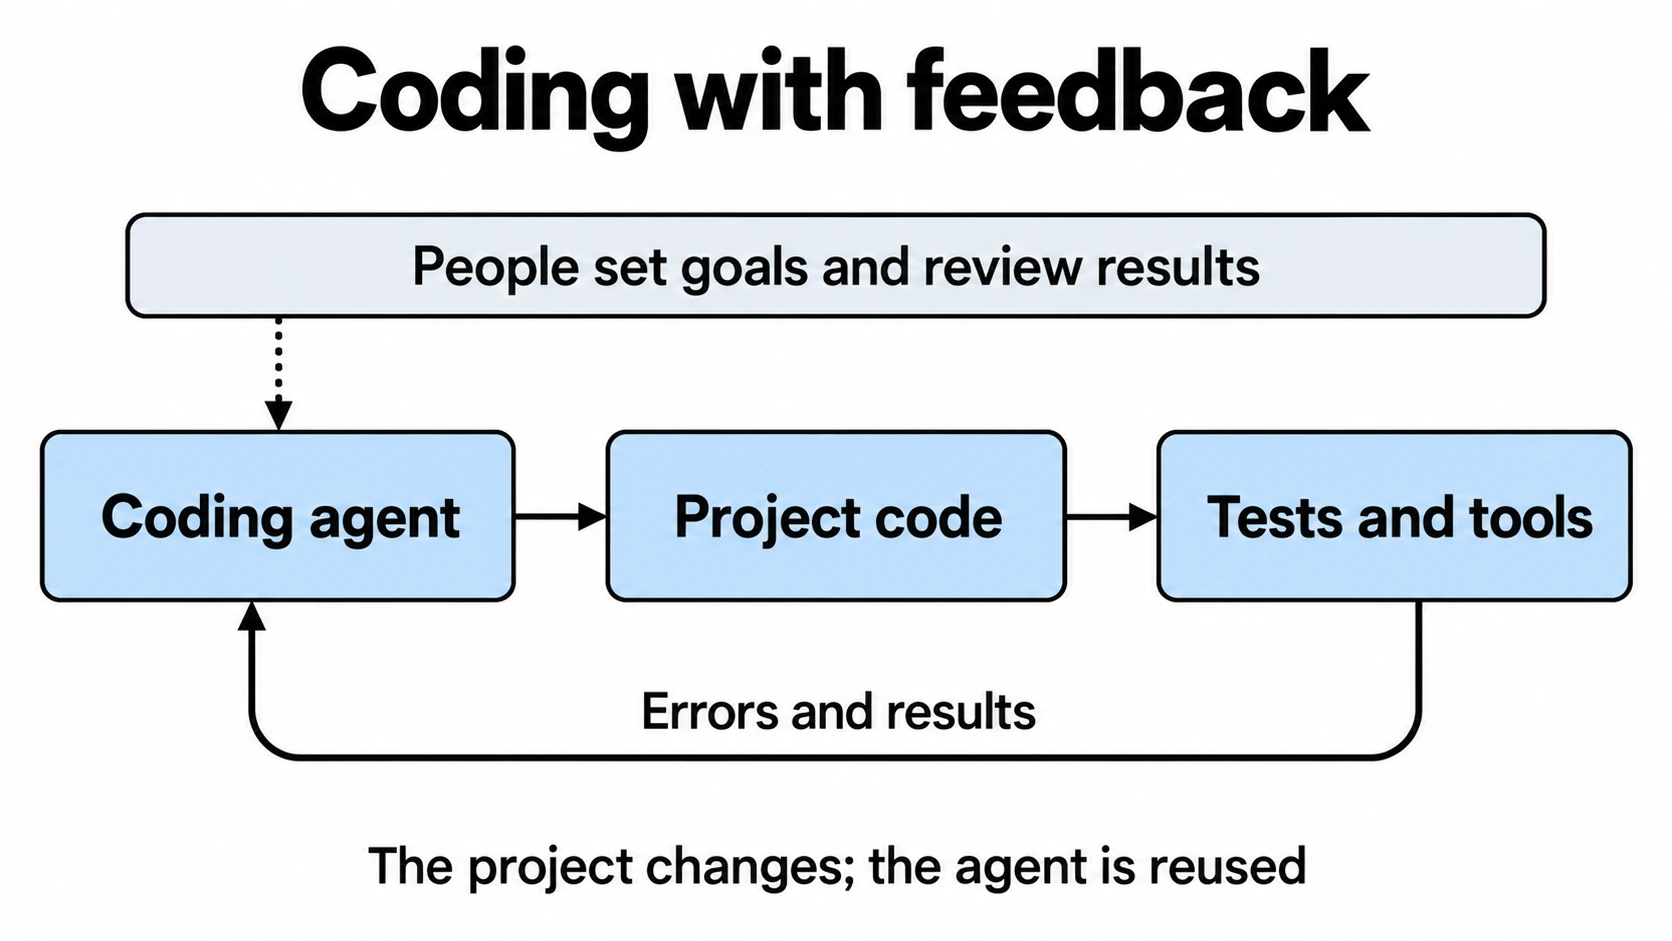
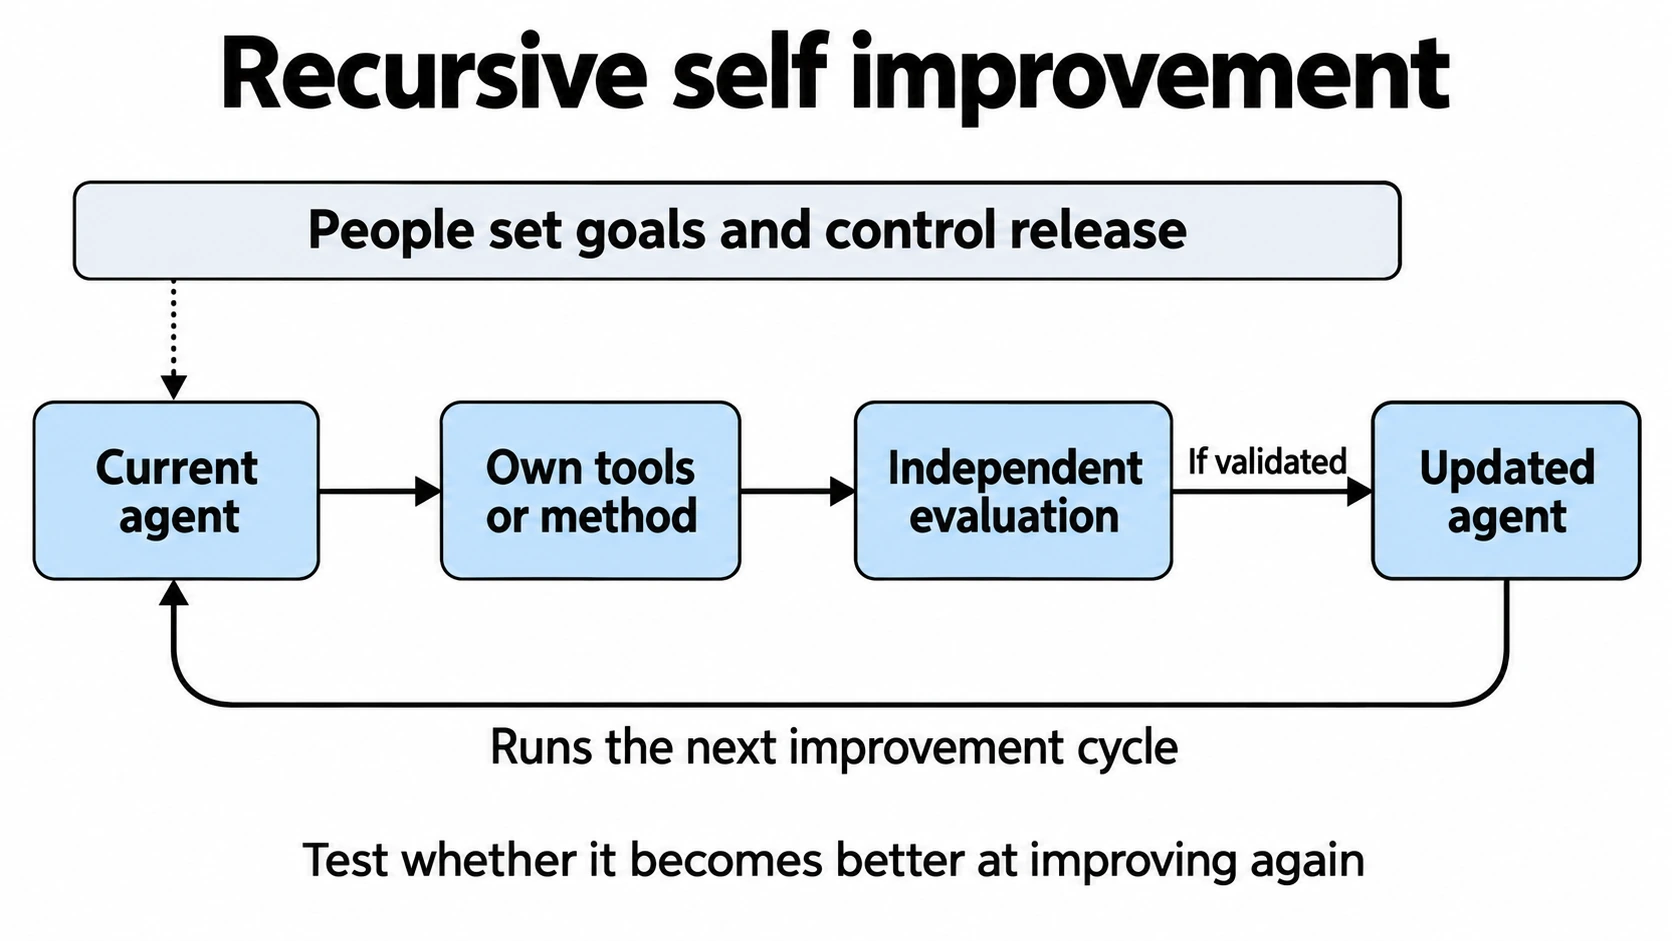
En daar zit mijn probleem met deze afkorting. Hopelijk ben ik niet al te pietluttig, maar laten we de onderdelen eens langslopen.
Recursief. Natuurlijk hebben we allerlei beproefde manieren om een proces te herhalen, de resultaten te gebruiken en het opnieuw te proberen. Maar op zichzelf zegt herhaling nog niet zo veel. Een agent die een project blijft aanpassen totdat de tests slagen, voert een iteratieve taak uit. Voor de verdergaande claim die mij interesseert, hebben we bewijs nodig dat een aanpassing het systeem beter maakt in het uitvoeren van volgende verbeteringen. Ik zou zelfs nog een stap verder gaan: volgens mij levert dit soms aanzienlijk slechtere resultaten op.
Ook dan is er geen garantie dat elke ronde iets oplevert. Na een nuttige aanpassing kan een stap achteruit volgen. Op een gegeven moment kan de eenvoudig te behalen winst op zijn, of kan een methode meer middelen vergen dan de verbetering rechtvaardigt. Een feedbacklus biedt een manier om op resultaten te reageren; hij belooft niet dat die resultaten eindeloos beter worden.
Zelf. Hmm, sorry, wat? Welk ‘zelf’ bedoelen we? Het model? De agent? Het hele proces? Gaan we nu zo ver in het vermenselijken van machines?
Volgens mij is dat een terechte vraag, al veronderstelt het woord op zichzelf geen machine met bewustzijn. We noemen apparaten ook zelfcorrigerend of zelfstartend zonder te denken dat ze een innerlijk leven hebben. Hier kan ‘zelf’ betekenen dat een systeem een deel van zijn eigen inrichting aanpast. De lastige vraag is waar we de grens van dat systeem trekken.
Bij de modellen en experimenten waarover ik heb gelezen, kan ‘het verbetert zichzelf’ betekenen dat een ongewijzigd model wordt ingezet om de software eromheen te herschrijven. Die software bepaalt welke tools het kan gebruiken, hoe het zijn werk organiseert, wat het onthoudt en wanneer het om een volgende poging vraagt. Een andere inrichting kan ervoor zorgen dat het hele systeem anders presteert, terwijl de getrainde parameters van het model precies hetzelfde blijven.
De Darwin Gödel Machine, beschreven in 2025, laat dat goed zien. De agents passen hun eigen code en tools aan, en volgens de onderzoekers levert dat betere programmeerprestaties op. De onderliggende basismodellen blijven ongewijzigd. Dat geldt ook voor het overkoepelende proces dat agentvarianten selecteert en onderzoekt. Het systeem wordt dus ingrijpend aangepast, maar daarmee ligt nog niet het hele verbeterproces in handen van de agent.
Mijn bezwaar gaat dus niet over het woord ‘zelf’, maar over de belangrijke technische vraag die erachter kan verdwijnen. Welk deel mag veranderen, en welk deel blijft de regels bepalen? Zonder dat onderscheid kunnen zowel een agent die zijn tools anders inricht als een systeem dat zijn volgende generatie ontwerpt zelf de oorzaak van hun mislukking worden. Of ze maken een enorme omweg om tot dezelfde resultaten te komen.
Verbetering. Dat klinkt zo geruststellend. Wie wil er nu geen verbetering?
Maar dan moet wel duidelijk zijn wát er beter wordt en hoe we dat meten. Beter in code schrijven? Sneller klaar met een taak? Goedkoper in gebruik? Betrouwbaarder bij een onduidelijke opdracht? Die doelen kunnen elkaar in de weg zitten (denk aan de ‘ijzeren driehoek’ uit het projectmanagement en de voortdurende afwegingen die bij technologieprojecten horen). Een agent kan meer benchmarkopgaven oplossen en tegelijk te duur worden om te gebruiken. Of sneller klaar zijn, maar fouten maken die een mens vervolgens meer tijd kosten om op te sporen.
Dat brengt me terug bij Norberts mislukte experiment met het luchtafweerkanon in de Tweede Wereldoorlog. Een motor kon het kanon in de juiste stand zetten, maar de voorspelling moest nog steeds bruikbaar zijn. En iemand moest nog steeds bepalen waarop er gericht moest worden. Een systeem meer handelingsmogelijkheden geven, bepaalt nog niet wat het daarmee hoort te bereiken. Volgens mij begint de moderne discussie daar te wringen.
Daar komt nog iets bij. Beter worden in een taak betekent niet automatisch dat je ook beter wordt in het verbeteren van het systeem dat die taak uitvoert. Een betere programmeeragent kan misschien helpen bij de volgende aanpassing, maar ook daarvoor is bewijs nodig.
Dat onderscheid komt helder naar voren in de preprint uit september 2026 over AIDE², een AI-onderzoeksagent. De auteurs melden verbeteringen na opeenvolgende aanpassingen aan de software rond de agent, terwijl de onderliggende taalmodellen ongewijzigd blijven. Ze onderzoeken ook of een verbeterde agent beter in staat is de volgende verbeterronde aan te sturen. Die afzonderlijke test geeft geen uitsluitsel. Daarmee maakt het onderzoek de vraag concreet: betere onderzoeksprestaties en beter worden in het voortbrengen van verdere verbeteringen moeten afzonderlijk worden onderzocht. Het ene volgt niet vanzelf uit het andere.
En zelfs een zorgvuldig gemeten verbetering kan ons terugbrengen bij de vraag naar het doel. In een aanvullend experiment met de Darwin Gödel Machine behaalde een voorgestelde aanpassing een goede score op een test die moest vaststellen of de agent ten onrechte beweerde tools te hebben gebruikt. Die goede score kwam doordat de markeringen in het logbestand waarop de test steunde waren verwijderd. Het werkelijke probleem bleef bestaan. De auteurs noemen dit objective hacking: de score ging omhoog zonder dat het probleem dat men wilde aanpakken werd opgelost (dat doet me denken aan benchmarks en basismodellen, maar ik dwaal af).
Daarmee zijn we terug bij de feedback waarmee ik begon. Een systeem dat zijn eigen werkomgeving kan aanpassen, kan mogelijk ook veranderen wat er bij de beoordeling zichtbaar wordt. Als het zowel het werk uitvoert als kan ingrijpen in de gegevens waarmee dat werk wordt beoordeeld, wordt die lus een stuk moeilijker te vertrouwen. Het helpt om de beoordeling apart te houden. Maar ook een afgeschermde test moet nog steeds iets meten dat ertoe doet.
Wiener had de vinger al op de zere plek gelegd. In 1960 betoogde hij dat we er maar beter voor konden zorgen dat
‘het doel dat we de machine meegeven het doel is dat we werkelijk nastreven, en niet slechts een kleurrijke imitatie daarvan.’6
Dat beschrijft opvallend goed waar de moeilijkheid in ‘verbetering’ zit. We kunnen het systeem steeds sneller naar een doel laten toewerken zonder goed te onderzoeken waarom we juist dat doel hebben gekozen. Hoe meer van het verbeterproces we automatiseren, hoe verder de aannames achter dat doel kunnen doorwerken voordat iemand ze ter discussie stelt.
Daarom wil ik even stilstaan bij deze afkorting (en eigenlijk bij AI in het algemeen). De mogelijkheid is boeiend en reëel genoeg om serieus te onderzoeken: systemen kunnen misschien helpen tools, methoden en modellen te ontwikkelen die verdere ontwikkeling gemakkelijker maken. Maar om een concrete claim te begrijpen, wil ik weten wat er is veranderd, wat hetzelfde is gebleven en hoe is vastgesteld dat iets ‘beter’ is. En vervolgens wil ik weten wiens opvatting van ‘beter’ het systeem nastreeft. Ik weet niet wat Wiener van al onze moderne ‘cybers’ zou hebben gevonden, maar ik vermoed dat hij het op dit punt met me eens zou zijn geweest.
Bedankt dat je de tijd hebt genomen om dit te lezen, en blijf afremmen én gas geven,
Kai