Voordat een nieuwe generatie kunstmatige intelligentie zich stort op de bergen data die we iedere dag produceren en consumeren, lijkt het me verstandig stil te staan bij bias: wat het is, hoe het ontstaat en welke risico’s eraan kleven.
Laten we met een definitie beginnen. Wat is bias?
‘Een voorkeur voor of tegen een idee, persoon of zaak, vaak zonder voldoende grond.’
Binnen kunstmatige intelligentie en datawetenschap wordt het woord bias voor verschillende zaken gebruikt. Een model heeft altijd een inductieve bias: aannames die bepalen welke patronen het gemakkelijker kan leren. Daarnaast kent een neuraal netwerk een wiskundige bias-term, de b in veel vergelijkingen. En ten slotte kan een systeem maatschappelijke vooringenomenheid of vertekening uit trainingsdata overnemen. Die betekenissen hangen samen, maar zijn niet hetzelfde. Juist daarom moeten we zorgvuldig zijn wanneer we over bias spreken.
Laten we bij het begin beginnen.
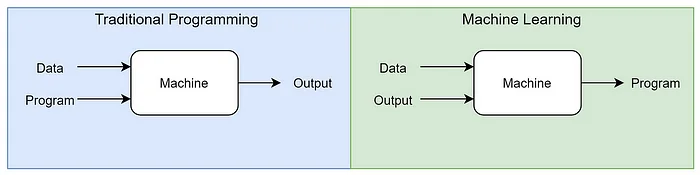
Dit diagram probeert ons duidelijk te maken dat het belangrijkste doel van een machinelearningmodel is een ‘functie’ te benaderen of te leren. In deze context verwijst een ‘functie’ naar een wiskundige relatie of regel die invoerdata (kenmerken) koppelt aan een gewenste uitvoer (doelen of labels).
Stel dat we een AI-systeem bouwen om spam in e-mail te detecteren. De functie moet de kenmerken (invoer) van een enorme database met e-mails onderscheiden en vervolgens het label ‘spam’ nauwkeurig aan een e-mail toekennen. Laten we enkele voorbeelden bekijken van de data waarmee we van x naar y willen komen:
- ‘Hoi, ik ben een prins en ik moet wat geld kwijt.’ (spam)
- ‘Hoi, ik heb zojuist de loterij gewonnen en ik wil dat jij mijn geld bewaart.’ (spam)
- ‘Hoi, ik ben van de helpdesk en ik zie dat je laptop kapot is.’ (spam)
- ‘Hoi, je moet je creditcardrekening voor het einde van de week betalen.’ (geen spam)
De kenmerken van deze voorbeelden zijn nogal vaag. We hebben geld, monarchie, gokken, creditcards en kapotte laptops. Het wordt een lange nacht vol aannames.
De functie die we willen leren, beschrijft de relatie tussen het label ‘spam’ en de kenmerken van de berichten. We beginnen met aannames op basis van patronen in de trainingsdata. Zodra het model die relatie goed genoeg benadert, laten we het voorspellingen doen over nieuwe, niet eerder bekeken berichten. Als dat werkt, zijn we op weg.
Onthoud vooral dat de aannames waarmee we dit leerprobleem afbakenen invloed hebben op wat het model kan ontdekken. Een sterke inductieve bias kan het leren versnellen, maar ook relevante mogelijkheden uitsluiten.
Met deze datavoorbeelden kom ik niet ver. Laten we ze een beetje aanpassen en kijken wat er gebeurt:
- ‘Hoi, ik ben een Nigeriaanse prins en ik moet wat geld kwijt.’ (spam)
- ‘Hoi, ik ben een Texaanse oma die niets van computers begrijpt. Ik heb zojuist de loterij gewonnen en ik wil dat jij mijn geld bewaart.’ (spam)
- ‘Hoi, ik ben Harmeet en werk bij een helpdesk. Ik zie dat je laptop kapot is.’ (spam)
- ‘Hoi, met Uri. Je moet je creditcardrekening voor het einde van de week betalen.’ (geen spam)
Ik heb de verschillen gemarkeerd, al waren ze nauwelijks te missen. Vanuit datawetenschappelijk perspectief hebben we kenmerken als nationaliteit, leeftijd en gender toegevoegd. Daardoor lijkt het voor het model gemakkelijker om een patroon te vinden, maar precies daar ontstaat het gevaar: voorspellende kracht is niet hetzelfde als een legitieme of eerlijke grond voor een beslissing.
Dit is vanzelfsprekend een enorme vereenvoudiging. Datawetenschap en machine learning zijn veel complexer. Je werkt met beperkte datasets, ruis, fouten, inconsistenties en irrelevante informatie. Vervolgens begint het moeizame menselijke werk: de data onderzoeken, hypotheses toetsen en de aanpak steeds bijstellen totdat de gegevens bruikbaar zijn. Iedere keuze in dat proces kan nieuwe aannames en vertekeningen introduceren.
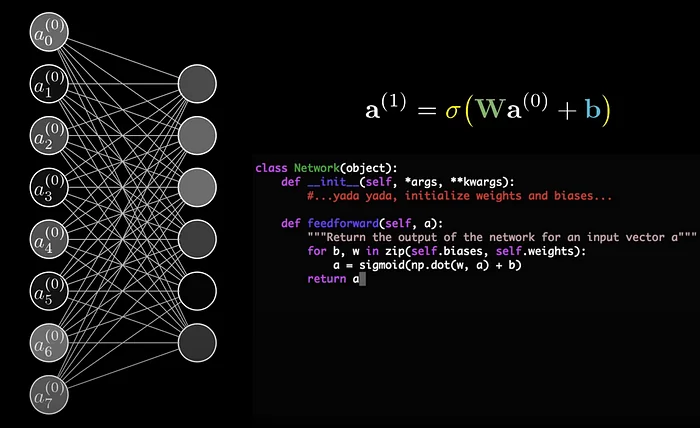
(218) 3Blue1Brown | YouTube
Bij deep learning heeft het woord bias ook een specifieke wiskundige betekenis. De b in deze afbeelding is een trainbare bias-term. Zo’n term verschuift de activatiedrempel van een neuron en maakt het netwerk flexibeler. Het netwerk leert deze waarden tijdens de training. Dat is iets anders dan maatschappelijke vooringenomenheid, al kunnen de patronen die het netwerk leert daar wel degelijk door worden beïnvloed.
Kortom: aannames, trainbare bias-termen en mogelijke maatschappelijke vertekening spelen ieder een rol in machine learning en deep learning. Nu deze technologieën overal opduiken, moeten we die verschillen begrijpen en helder benoemen.
Laten we onze scenario's rond bias uitbreiden tot meer dan spam, zodat duidelijk wordt waar dit naartoe gaat. Enkele voorbeelden van bias in AI:
- Werving en selectie: een nieuw, superkrachtig AI-systeem helpt een recruitmentbureau de beste kandidaten voor nieuwe opdrachten te vinden. Het systeem wordt getraind op historische gegevens van alle opdrachten van het bureau. Het verwerkt persoonlijke informatie en toont voor iedere kandidaat een waarschijnlijkheidsscore voor een nieuwe opdracht, nog voordat iemand een cv heeft bekeken of met de kandidaat heeft gesproken.
- Rechtshandhaving: AI-systemen ondersteunen de beoordeling van voorwaardelijke invrijheidstelling. Het systeem is getraind om het risico op recidive te beoordelen en gebruikt meerdere toepassingen, databases en historische gegevens om een aanbeveling te doen voordat de persoon is geïnterviewd.
- Beslissingen over krediet en leningen: opnieuw wordt het systeem getraind op historische datapatronen van schulden en aflossingen. Het weigert automatisch krediet of een lening, zonder menselijke tussenkomst of interactie. Datagedreven besluitvorming.
- Gezondheidszorg: AI-tools worden in de zorg gebruikt om afwijkingen te detecteren. Het model wordt getraind in de beste ziekenhuizen van landen die de middelen hebben om data volgens hoge standaarden te verzamelen en ordenen.
In al deze gevallen hoef je niet bijzonder creatief te zijn om te zien hoe AI systemische bias versterkt.
Bias in AI is niet iets dat we achteloos kunnen negeren. Naarmate deze technologie zich verspreidt, zal de invloed van bias exponentieel groeien. Bias in AI gaat veel verder dan afzonderlijke bedrijfssituaties en strekt zich uit tot een wereldwijd maatschappelijk vraagstuk.
Ik ga nog een stap verder: machines zijn niet de enige systemen met ingebouwde bias. Ook menselijke vooringenomenheid is een onvermijdelijk en fundamenteel onderdeel van onze oneindig complexere manier van denken.
Neurowetenschapper Heather Berlin illustreert dit met wat zij onze ‘perceptiebox’ noemt. Onze waarneming ontstaat uit een combinatie van interne verwachtingen, gevormd door eerdere ervaringen, en zintuiglijke informatie uit onze omgeving. De voortdurende wisselwerking tussen die processen creëert een persoonlijke perceptiebox die per definitie subjectief is. Laten we die gedachte onderzoeken en vervolgens de koppeling met bias in AI maken.
De waarnemingslus van de hersenen:
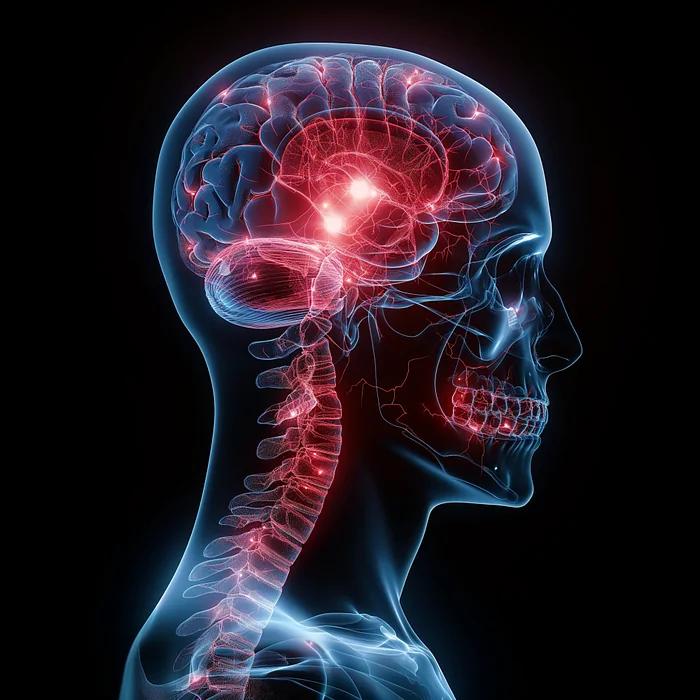
Laten we dit in twee onderdelen opsplitsen. Het is belangrijk te vermelden dat wat ik schrijf een enorme vereenvoudiging is, maar dat is precies de bedoeling. Ik wil illustreren hoe we door middel van bias met onze eigen innerlijke en uiterlijke complexiteit omgaan.
Het externe proces omvat het omzetten van zintuiglijke data uit onze omgeving in elektrische signalen. Neem slechts één stukje van de puzzel: de oogzenuw. Die bestaat uit meer dan een miljoen zenuwvezels en verricht zwaar werk terwijl hij een stroom informatie over onze omgeving naar de visuele cortex stuurt.
- Het menselijk oog kan ongeveer tien miljoen kleuren onderscheiden en heeft een resolutie van circa 576 megapixels.
- De hersenen verwerken beelden die het oog ziet op allerlei manieren, van elementair en ruimtelijk tot beweging en diepte. Dit gebeurt in ongeveer 13 milliseconden, wat (belangrijk) sneller is dan een oogwenk.
- De hersenen kunnen de visuele cortex voor andere functies inzetten, zoals horen of voelen.
- De oogzenuw verstuurt visuele informatie van het oog naar het centrale zenuwstelsel met de verbazingwekkende snelheid van tien miljoen bits per seconde (hij doet veel meer, maar dit is de eenvoudige versie).
Deze verwerking van zintuiglijke informatie vindt tegelijk met talloze andere bewuste en onbewuste processen plaats. Ik schrijf dit artikel bijvoorbeeld in de trein naar kantoor in Amsterdam. Mijn visuele cortex verwerkt niet alleen de laptop en de woorden die tijdens het typen verschijnen, maar ook mijn omgeving en de beker koffie die ik optil. Tegelijk luister ik naar muziek, adem ik en neem ik geuren waar. Ik kan nog wel even doorgaan, maar je begrijpt wat ik bedoel.
Het interne proces is ‘waar de magie gebeurt’, zoals men in de jaren nul zei. Dr. Berlin stelt dat het menselijk brein wordt gevormd door de signalen die het gedurende ons leven ontvangt en verwerkt. Stel je de hersenen voor als een blanco lp. Alle verwerkte en omgezette visuele informatie kerft groeven in de plaat van ons brein. Wanneer we op ‘play’ drukken, raakt de naald de plaat en speelt die een mash-up af van deze informatie en alle andere factoren die onze ‘perceptiebox’ gedurende ons leven hebben gevormd. Het is niet vergezocht om te stellen dat de groeven op die plaat uniek zijn. Onze verwachtingen, dromen, verlangens en angsten zijn eveneens verschillend, zelfs als we bepaalde patronen met anderen delen.
Hier ontstaat de verbinding met AI. Zowel mensen als modellen proberen overweldigende complexiteit hanteerbaar te maken door patronen te herkennen. We groeperen signalen, vergelijken ze met eerdere ervaringen en gebruiken die vereenvoudiging om te beslissen en te communiceren. Dat werkt buitengewoon goed, maar ieder patroon laat details weg en kan bestaande aannames versterken.
Laten we hetzelfde spamvoorbeeld nu door een mens laten uitvoeren. Gefeliciteerd: je hebt mijn denkbeeldige neef Ben Bergin aangenomen als menselijk spamfilter. Hij leest je e-mails en markeert ze als spam of geen spam. Ja, dat is griezelig.
We trainen hier geen model. Ben hoeft geen trainingsvoorbeelden te verzamelen, verliesfuncties te berekenen of modelgewichten af te stellen. Zijn geëvolueerde apenbrein neemt het werk over, inclusief alle ervaringen en aannames die daarin al aanwezig zijn.
Het is maandagochtend en Ben heeft koffie gehad. Laten we beginnen met labelen:
- ‘Hoi, ik ben een prins en ik moet wat geld kwijt.’ (spam)
- ‘Hoi, ik heb zojuist de loterij gewonnen en ik wil dat jij mijn geld bewaart.’ (spam)
- ‘Hoi, ik ben van de helpdesk en ik zie dat je laptop kapot is.’ (spam)
- ‘Hoi, je moet je creditcardrekening voor het einde van de week betalen.’ (geen spam)
Makkelijk, toch? Bens menselijke brein heeft de middelbare school doorlopen en weet dat al deze scenario's volkomen belachelijk zijn, behalve het laatste. Door naar de volgende stap van de test. Laten we enkele herkenbare elementen aan onze data toevoegen:
- ‘Hoi, ik ben een Nigeriaanse prins en ik moet wat geld kwijt.’ (spam)
- ‘Hoi, ik ben een Texaanse oma die niets van computers begrijpt. Ik heb zojuist de loterij gewonnen en ik wil dat jij mijn geld bewaart.’ (spam)
- ‘Hoi, ik ben Harmeet en werk bij een helpdesk. Ik zie dat je laptop kapot is.’ (spam)
- ‘Hoi, met Uri. Je moet je creditcardrekening voor het einde van de week betalen.’ (geen spam)
Functioneel gezien kan Ben deze e-mails nog steeds objectief bekijken. Persoonlijk heb ik geen enkel probleem met zijn... wacht eens even.
Maar er klopt iets niet.
Laten we met de problemen beginnen en daarna naar de patronen gaan.
- Ingebeelde objectiviteit. De versie van menselijke objectiviteit waarvan we allemaal wensen dat zij bestaat, maar die niet bestaat. Als we de uitleg van Heather Berlin volgen, is niets aan Bens brein objectief. Het enige probleem is dat hij zichzelf (en iedereen met wie hij praat) kan vertellen dat dit wel zo is.
- Bens manier van labelen is niet alleen een kwestie van regels en logica. Als mens maakt hij deel uit van de wereld die hij beoordeelt. Daar komt de onvoorspelbaarheid van de werkelijkheid bij: onverwachte gebeurtenissen en nieuwe context kunnen ieder patroon of model ondergraven.
- Ben is een tweedimensionale, fictieve neef zonder achtergrondverhaal. Zodra we dat aan het scenario toevoegen, wordt het lastig. Misschien heeft Ben een partner uit Punjab en houdt hij van Indiaas eten, muziek en cultuur. Mogelijk heeft hij daardoor een natuurlijke voorkeur voor alles wat maar op het subcontinent lijkt. Wanneer hij een brief van Harmeet leest, is hij op basis van zijn persoonlijke (en voor ons onzichtbare) bias misschien eerder geneigd op ‘geen spam’ te klikken.
- Na de eerste honderd e-mails zoekt Ben, zoals ieder mens, naar vaste patronen om sneller te kunnen werken. Patroonherkenning is een bijzonder menselijke manier om grote hoeveelheden informatie hanteerbaar te maken.
Wat doen we dus? Stoppen we simpelweg, trekken we de stekker eruit en stellen we dat bias onvermijdelijk is? Kijken we weg van de systemische ongelijkheden die we de machines van morgen voeren?
Volgens mij bestaat hiervoor een duidelijke oplossing die ook het vertrouwen in het gebruik van AI-modellen zal vergroten.
Binnen de digitale geesteswetenschappen bestaat een krachtige term: ‘datafeminisme’. Zeker als man gebruik ik die term met enige bescheidenheid. De kern is dat we niet wegkijken van ongelijkheid en bias, maar ze actief onderzoeken en benoemen. Transparantie is daarbij een van onze belangrijkste hulpmiddelen. Het gaat niet alleen om de vraag welke databronnen voor een model zijn gebruikt, maar ook om wie eraan heeft gewerkt: welke mensen, organisaties, landen en culturen waren betrokken, en welke waarden en politieke overtuigingen brachten zij mee? Dat niveau van openheid gaat veel verder dan een label als ‘open source’. Volgens mij is het een ontbrekend puzzelstuk in deze eerste jaren van de AI-revolutie.
Erkennen dat AI-systemen bias kunnen bevatten, is de eerste stap om het probleem aan te pakken. Onderzoekers en ontwikkelaars moeten mogelijke vertekening tijdens het hele ontwikkelproces actief opsporen en beperken. Dat vraagt om diverse en representatieve trainingsdatasets, regelmatige controles op ongelijke uitkomsten en ethische afwegingen tijdens zowel ontwerp als inzet.
Ook transparantie en verantwoordelijkheid zijn cruciaal in de strijd tegen bias. AI-systemen moeten worden ontworpen met transparante en uitlegbare algoritmen, zodat bevooroordeelde uitkomsten kunnen worden geïdentificeerd en gecorrigeerd. Daarnaast kunnen diverse teams in het ontwikkelproces verschillende perspectieven inbrengen en potentiële bias vroeg signaleren.
Bias is onderdeel van de menselijke ervaring en verweven met de manier waarop onze hersenen de wereld waarnemen. Naarmate we meer op AI-systemen vertrouwen, moeten we beseffen dat ook die systemen menselijke aannames en maatschappelijke ongelijkheid kunnen overnemen. Door de bronnen van vertekening zichtbaar te maken, duidelijk te communiceren en actief te beperken, stellen we mensen in staat betere keuzes te maken. Zo zetten we concrete stappen naar eerlijkere en rechtvaardigere AI-systemen.
The Night Bakery, kunst van Kaoru Yamada | Society6
Bedankt voor het lezen,
Kai