Wie een taalmodel als ChatGPT gebruikt, ziet zowel baanbrekende technologie als talloze technische en praktische mislukkingen: momenten waarop de intelligente technologie van de toekomst struikelt en languit gaat. In dit artikel probeer ik een van de redenen uit te leggen waarom een taalmodel niet doet wat je ervan verwachtte.
(Mislukking is een uitstekend vertrekpunt voor een artikel over AI. Ik houd veilig het midden tussen de pessimisten, de optimisten en de mensen die denken: ‘wat gebeurt er in hemelsnaam met AI?’)
Om uit te leggen waarom ChatGPT faalt, neem ik je niet mee over de lange, kronkelige weg van de architectuur van een transformermodel. Ook ga ik het niet hebben over de fundamentele wiskunde van neurale netwerken. Deze keer vertrouw ik op de informatietheorie van Claude Shannon, omdat die volgens mij een veel rijker begrip biedt van de uitdagingen voor een taalmodel. De theorie maakt ook duidelijk hoe zulke modellen hun magie kunnen uitvoeren in het complexe en prachtige landschap van menselijke taal. Hopelijk begrijp je aan het einde van dit artikel wat mensen bedoelen wanneer zij ChatGPT een ‘stochastische papegaai’ noemen, wat enkele redenen voor mislukkingen kunnen zijn en, nog belangrijker, wat de probabilistische aard van deze technologie inhoudt. Daarom zie ik haar minder als een rekenmachine voor taal en meer als een weersvoorspeller voor zinsbouw.
Iedere goede reis begint met een uitdaging, en die van het taalmodel is werkelijk gigantisch. Zoals bij iedere geëvolueerde aap schiet mijn vermogen tekort wanneer ik een concept van deze omvang en schaal doeltreffend probeer te beschrijven. Daarom gebruik ik een combinatie van statistieken en persoonlijke ervaring om duidelijk te maken hoe uitdagend menselijke taal kan zijn.
Het eerste wat ChatGPT moet doen om mij ervan te overtuigen dat het geen overgehypete technologische rommel is, is de indruk wekken dat het mijn versie van het Engels begrijpt.
Laten we de verzameling woorden uitpakken die mijn tweetalige brein heeft opgebouwd.
Volgens Wikipedia en Wiktionary:
Het Engels telt ongeveer 730.000 lemma’s: basisvormen, dus we tellen alleen ‘dig’ en niet ‘digging’ of ‘digdug’.
Het Nederlands telt er ongeveer 400.000, waarbij we het Middelnederlands buiten beschouwing laten.
Laten we iets dieper graven. Een psycholinguïstisch onderzoek naar het Nederlands en Engels, toevallig precies onze twee talen, komt uit op het volgende:
De gemiddelde Amerikaan (of Australiër misschien) heeft een woordenschat van 42.000 woorden.
Onderzoek: de meeste Amerikaanse volwassenen kennen meer dan 42.000 woorden , UPI.com
De gemiddelde Nederlander heeft een woordenschat van 38.000 woorden.
Nederlanders hebben grotere woordenschat dan Vlamingen | VRT NWS: nieuws
Het feit dat ik dit in het Engels schrijf, betekent dat ik een van deze twee aantallen flink kan verkleinen (raad welke). Sommige woorden worden uiteraard veel vaker hergebruikt dan andere, en mijn actieve woordenschat is veel kleiner dan beide aantallen. Ik heb ook woordcombinaties nodig om taal betekenis te geven. Die van mij heb ik gedurende een leven lang lezen, praten, luisteren, kijken en kopiëren geleerd. Het zijn woorden die netjes bij elkaar passen en prettig aanvoelen tussen mijn zachte hersenkwabben.
Frontiers | Hoeveel woorden kennen we? Praktische schattingen van de omvang van de woordenschat op basis van de woorddefinitie, de mate van taalinvoer en de leeftijd van de deelnemer (frontiersin.org))
Ik maak ook fouten wanneer ik zinnen bouw, en ChatGPT moet die eveneens begrijpen. Soms gebruik ik geluiden in plaats van woorden: ‘meh’ en ‘pffft’ hebben voor mij meerdere betekenislagen. Ik gebruik ze net zo vaak als uitdrukkingen die, voor zover ik weet, alleen mijn familie (ten onrechte) gebruikt. Bijvoorbeeld ‘monkey-shines’ wanneer het regent terwijl de zon schijnt, of ‘Holy Guacamoly’. Ook zijn er enkele woorden die ik sinds de middelbare school verkeerd spel, alsof een vreemde neurologische hapering nooit is verdwenen. (beuaracracy... aaargh)
Om deze uitdaging aan te gaan heeft ChatGPT veel tekst geconsumeerd. Het model heeft vrijwel het hele internet en nog veel meer verslonden. Ieder boek, iedere pdf, wetenschappelijke publicatie, blogpost en Reddit-reactie die een scraper kan bereiken, is op één grote stapel woord-, letter- en zinscombinaties gelegd. Teams van experts verfijnen die enorme hoeveelheid taaldata keer op keer, totdat er iets bruikbaars ontstaat. Vervolgens gebruikt ChatGPT waarschijnlijkheidsscores om de puzzel ‘wat is het volgende woord in deze zin?’ op te lossen. (Lees mijn andere artikelen voor meer informatie en inzichten over de werking en architectuur van dit onderwerp.)
Stephen Wolfram geeft in zijn uitstekende artikel over de werking van GPT een eenvoudig voorbeeld van dit proces:
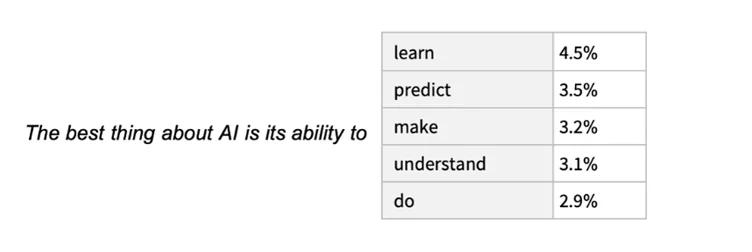
Wat doet ChatGPT en waarom werkt het? | Stephen Wolfram Writings
Het woord met de hoogste waarschijnlijkheid wint! GPT maakt deze zin dus af met het woord ‘learn’.
Zoals 3Blue1Brown in deze uitstekende YouTube-video uitlegt, wordt dit percentage bepaald door de positie van het woord in de vectorruimte ten opzichte van andere woorden. Die contextafhankelijke ruimte verschuift mee met de overige woorden in de zin.
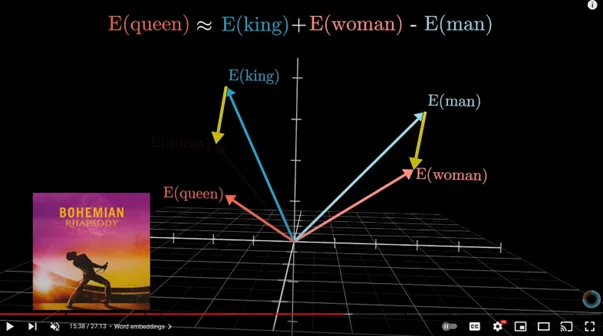
Uit de geweldige visuele uitleg over embeddings:
Het addertje onder het gras is dat het aantal mogelijke woordcombinaties letterlijk eindeloos is, voor mens én machine en of het nu om Frans, Japans of Nederlands gaat.
Terug naar de menselijke kant van de uitdaging:
Ik ben een van de 1,4 miljard mensen die het Engels gebruiken. Laten we aannemen dat al die mensen een unieke relatie met de taal en een verschillende actieve woordenschat hebben. Om het nog lastiger te maken verandert de taal voortdurend, net als de culturele context.
Noam Chomsky haalt beroemd genoeg zijn neus op voor het idee van waarschijnlijkheid en taal:
‘Het begrip waarschijnlijkheid van een zin is volkomen nutteloos.’
Stephen Wolfram parafraseert de onmogelijke aard van deze uitdaging wanneer hij schrijft:
‘Maar met 40.000 gangbare woorden zijn er alleen al 1,6 miljard mogelijke 2-grams en 60 biljoen mogelijke 3-grams. We kunnen de waarschijnlijkheden van zelfs al deze combinaties dus onmogelijk schatten op basis van de beschikbare tekst. Wanneer we bij “essayfragmenten” van twintig woorden komen, is het aantal mogelijkheden groter dan het aantal deeltjes in het universum. In zekere zin zouden ze dus nooit allemaal kunnen worden opgeschreven.’
Hoe gaat ChatGPT om met een uitdaging van eindeloze waarschijnlijkheden wanneer het zelf probabilistisch is? Of poëtischer geformuleerd: hoe kun je een probleem oplossen wanneer je er zelf deel van uitmaakt?
Taal kun je niet ‘oplossen’, maar je kunt de waarschijnlijkheid van je model wel verbeteren. Daarom stelde ik dat ChatGPT meer gemeen heeft met een weersvoorspeller dan met een rekenmachine. Hoe verbeteren we de waarschijnlijkheidsscores van GPT? Je moet de informatie binnen en rond het probleem kunnen kwantificeren. Gelukkig bestaat daar een theorie voor: de informatietheorie, die al sinds de jaren vijftig bij ons is. De informatietheorie en een van haar kernelementen, entropie, helpen ons die waarschijnlijkheden te verbeteren, ongeacht de complexiteit.
De informatietheorie is ontwikkeld door Claude Shannon. Om snel duidelijk te maken hoe belangrijk deze man was, volgt hier een lijst met zijn grootste bijdragen aan de computerwetenschap:
- Bits
- Theorie van digitale schakelingen
- De fundamenten van moderne cryptografie
- De wiskunde van (digitale) communicatie
- De Shannon-limiet (de maximumsnelheid voor informatie-uitwisseling)
- De eerste draagbare computer
- Informatietheorie (entropie)
Deze theorieën vormen de basis van modern computergebruik. Een film op Netflix streamen, deelnemen aan een Teams-gesprek, een document in de cloud opslaan of ChatGPT vragen je rapport samen te vatten: ze leunen allemaal zwaar op de wiskundige bijdragen van Claude Shannon.
Om de prestaties van ons taalmodel te verbeteren hebben we vier ingrediënten:
Stochastische data: data die tot op zekere hoogte willekeurig en onvoorspelbaar zijn. Deze willekeur is inherent aan veel natuurlijke en kunstmatige processen, van schommelingen in aandelenkoersen tot het genereren van tekst door taalmodellen. Wie stochastische data wil begrijpen, moet weten hoe waarschijnlijk bepaalde uitkomsten zijn (waarschijnlijkheid) en hoe onverwacht die uitkomsten kunnen zijn (verrassing).
Waarschijnlijkheid in stochastische data:
Waarschijnlijkheid meet de kans dat een gebeurtenis binnen een verzameling mogelijke uitkomsten optreedt. Bij stochastische data helpen deze waarschijnlijkheden te voorspellen wat er hierna kan gebeuren op basis van waargenomen patronen of bekende verdelingen. Bijvoorbeeld:
- Bij weersverwachtingen helpen waarschijnlijkheden de kans op regen of zon te voorspellen.
- In financiële modellen helpen waarschijnlijkheden koersbewegingen of economische veranderingen in te schatten.
Deze waarschijnlijkheden zijn cruciaal, omdat zij de ruggengraat vormen van de manier waarop we het gedrag van stochastische systemen modelleren en voorzien.
Verrassing in stochastische data:
Verrassing kwantificeert hoe onverwacht een uitkomst is, gegeven een verzameling waarschijnlijkheden. Het begrip hangt nauw samen met informatie-inhoud. Uitkomsten met een kleinere kans bevatten meer ‘informatie’ wanneer zij toch optreden, omdat ze verrassender zijn.
De mate van verrassing van een uitkomst kan wiskundig omgekeerd evenredig zijn met de waarschijnlijkheid ervan:
- Zeer waarschijnlijke gebeurtenissen veroorzaken weinig verrassing wanneer ze optreden (bijvoorbeeld zonnig weer voorspellen in een woestijn, want dat ligt voor de hand).
- Minder waarschijnlijke gebeurtenissen veroorzaken meer verrassing wanneer ze optreden (sneeuwval in een woestijn is bijvoorbeeld bijzonder verrassend).
Entropie:
In de context van stochastische data meet entropie de gemiddelde verrassing over alle mogelijke uitkomsten, gewogen naar hun waarschijnlijkheid. Zij levert één waarde die de onzekerheid of wanorde in de dataset samenvat. Zo werkt het:
- Als iedere mogelijke uitkomst even waarschijnlijk is, is de entropie hoog. Er bestaat dan veel onzekerheid over de volgende uitkomst. Dit scenario maximaliseert de verrassing, omdat iedere specifieke uitkomst even onverwacht is.
- Als één uitkomst veel waarschijnlijker is dan de andere, is de entropie lager. Er is minder onzekerheid en dus minder verrassing over wat er hierna gebeurt.
De grote hoeveelheid informatie in een verrassende uitkomst kan voor een datawetenschapper net zo waardevol zijn als uitkomsten met lage entropie.
(Terzijde: als je ooit de uitspraak ‘LLM's zijn slechts een stochastische papegaai’ ziet, bedoelt men dit: het taalmodel produceert woorden uit zijn trainingscorpus op basis van waarschijnlijkheden. Net als een papegaai heeft het geen idee wat het werkelijk zegt.)
Hier zijn twee uitstekende voorbeelden van hoe dit werkt:
Een potje Wordle:
Blauwe kippen:
Hopelijk heb ik samen met deze uitstekende bronnen duidelijk kunnen maken hoe uitdagend menselijke taal voor een AI-model is en waarom het model bij sommige verzoeken de bal laat vallen.
Informatietheorie is een cruciaal hulpmiddel voor taalmodellen, omdat zij onverwachte en niet eerder waargenomen gegevens (zoals mijn zelfingenomen avocadodip) beter laat voorspellen en classificeren. Afwijkingen kunnen zo worden omgezet in constructieve elementen voor betere modellen en beslisbomen. AI-ontwikkelaars gebruiken informatietheorie om datasets voor RAG-oplossingen te segmenteren en te ordenen, of simpelweg om te bepalen waar data moet worden gesplitst, zodat uitdagingen in kleinere stappen kunnen worden aangepakt.
Bedankt voor het lezen. Als ik iets heb gemist of als je verder wilt praten over entropie en data, stuur me dan een bericht!
Kai