Efficiënter, beter controleerbaar en toegankelijker
Taalmodellen behoren tot de meest vernieuwende toepassingen van kunstmatige intelligentie en maken een nieuwe generatie digitale hulpmiddelen mogelijk. Hun vermogen om menselijke taal te verwerken en te produceren heeft de manier waarop we werken ingrijpend veranderd. Organisaties voeren de technologie dan ook in hoog tempo in. In The Coming Wave beschrijft DeepMind-oprichter Mustafa Suleyman de krachten die bijna vanzelf lijken te ontstaan wanneer een revolutionaire technologie zich verspreidt. Een van zijn belangrijkste punten is dat zo’n technologie onvermijdelijk efficiënter met middelen moet leren omgaan. De economische logica is eenvoudig: brede toepassing wordt pas mogelijk wanneer de productiekosten dalen. Grote taalmodellen zijn indrukwekkende technologische prestaties, gebouwd met extreem krachtige computers en draaiend in complete serverparken. Ze zijn veel dingen, maar goedkoop zijn ze niet.
Daar komen kleine taalmodellen, of SLM’s, in beeld als overtuigend alternatief voor hun grotere tegenhangers. Ze vragen minder rekenkracht om te ontwikkelen en te draaien. Daardoor worden finetuning en training beter beheersbaar en is effectief toezicht realistischer. Hun aantrekkingskracht ligt in de combinatie van efficiëntie, veelzijdigheid en geschiktheid voor specifieke toepassingen.
Om je een beeld te geven van het verschil in omvang tussen een klein en een groot taalmodel:
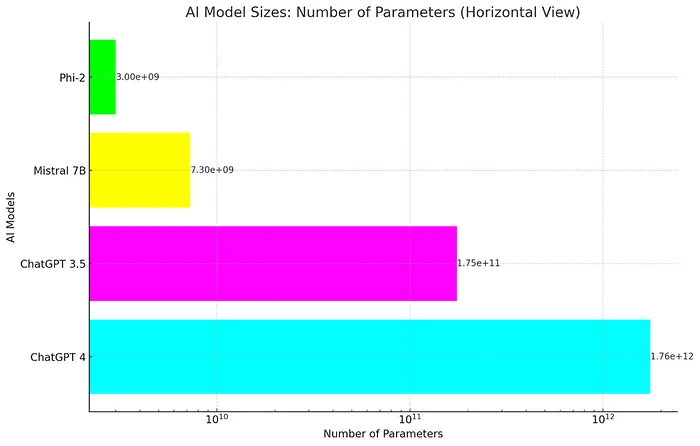
ChatGPT 4 zou naar verluidt ongeveer 1,76 biljoen parameters hebben en op een mixture-of-expertsarchitectuur draaien.
ChatGPT 3.5 heeft naar schatting 175 miljard parameters en draait op uitgebreide clusters van hoogwaardige processors die door Nvidia worden geleverd.
Mistral 7B van de Franse startup Mistral draait op 7,3 miljard parameters. Je kunt het downloaden en uitvoeren op een moderne gaminglaptop die bij de plaatselijke elektronicawinkel te koop is.
Phi-2 van Microsoft is nog kleiner. Hoewel het model vooral op programmeertaken is gericht, biedt het met slechts 3 miljard parameters een kijkje in de toekomst. Het kan zich goed meten met modellen die 25 keer groter zijn.
Door hun kleinere omvang zijn SLM’s rekenkundig aanzienlijk efficiënter dan grotere modellen. Innovatie bloeit in deze subcultuur van AI, waar vernieuwende benaderingen worden ontwikkeld om hun mogelijkheden maximaal te benutten. Sommige AI-experts gebruiken grotere modellen om hoogwaardige datasets te maken en geven die vooraf getrainde parameters vervolgens door aan een SLM. Andere fascinerende innovaties voegen taalmodellen samen tot een soort hybride model. Veel van deze innovatie wordt mogelijk doordat een klein model past binnen de beperkte middelen van universiteiten, studenten en kleinere teams van engineers.
Dat is vanuit academisch perspectief positief, maar voor een concrete toepassing tellen vooral de prestaties. Taalmodellen vergelijken is lastig: menselijke taal laat zich niet eenvoudig in één maatstaf vangen. Benchmarking is daarom een vakgebied op zich. Enkele vooraanstaande academische instellingen publiceren ranglijsten die voortdurend worden bijgewerkt.
LMSys Chatbot Arena-ranglijst, een Hugging Face Space van lmsys
De ranglijst van medio januari 2024 toont een wereld die wordt gedomineerd door miljarden parameters. Vanaf ongeveer de zeventiende plaats verandert het beeld echter en wordt de benchmark een mix van modellen met zeer uiteenlopende afmetingen.
Voordelen van kleine taalmodellen
· Toegankelijkheid
· Controleerbaarheid
· Kosten
· Aanpasbaarheid
· Energiezuinigheid
SLM’s bieden verschillende voordelen ten opzichte van grote taalmodellen, of LLM’s. Je kunt ze bijvoorbeeld finetunen of aanpassen met gangbare consumentenhardware. Bij grotere modellen is dat door hun omvang, beperkte toegankelijkheid en gespecialiseerde processors veel moeilijker. Doordat kleine modellen een beheersbaar aantal parameters hebben en vaak als open-weightmodel beschikbaar zijn, zijn ze beter te onderzoeken en te controleren. Een ontwikkelteam kan problemen met in-context learning daardoor sneller herkennen en aanpakken. Ook wijzigingen zijn minder ingrijpend: het verbeteren of vervangen van trainingsdata kost aanzienlijk minder tijd en geld.
Kleiner betekent niet minder vooruitgang
SLM’s worden steeds breder toegepast en doorbreken het patroon van groot, groter, grootst dat de technologiesector vaak kenmerkt. In 2024 verwachtte ik nieuwe en nog grotere versies van ChatGPT en Gemini. Tegelijkertijd zag ik ruimte voor een diverser ecosysteem van kleine, trainbare modellen die specifieke toepassingen binnen organisaties ondersteunen, in plaats van persoonlijke productiviteit op wereldschaal te bedienen.
Kleine taalmodellen kunnen ook heel effectief met grotere modellen worden gecombineerd. Meta gebruikt het Purple Llama-model bijvoorbeeld als beveiligingsinstrument binnen een generatief AI-product. Purple Llama, AI bij Meta
Als je organisatie bijvoorbeeld Copilot of ChatGPT Enterprise gebruikt, kan een kleiner model worden getraind op intern beleid, governance en richtlijnen. Zo’n model kan vervolgens de uitvoer van een groter model controleren. Dat is een concrete en haalbare toepassing.
Ook de combinatie van een klein taalmodel met geavanceerdere machinelearningmodellen biedt interessante mogelijkheden. Het SLM vertaalt menselijke taal en intentie dan voor de achterliggende systemen.
Kleine doorbraken in het jaar van de grote taalmodellen
Er zijn verschillende SLM’s ontwikkeld die ons begrip van taalmodellen hervormen. De Franse AI-startup Mistral ontwikkelde bijvoorbeeld een nieuw model genaamd Mixtral 8x7B. Het combineert verschillende kleinere modellen die zijn getraind voor uiteenlopende taken en werkt daardoor efficiënter. Het kleine 7B-model kan bovendien op een gewone consumentenlaptop draaien. Dat opent nieuwe mogelijkheden en routes voor ontwikkelaars en eindgebruikers.
Ook Microsoft zette met de introductie van Phi-2 een stap vooruit. Dit krachtige SLM heeft 2,7 miljard parameters, aanzienlijk meer dan voorganger Phi-1.5 met 1,3 miljard parameters.
Hier is een lijst met links naar de populairdere SLM’s:
Mistral AI | Open-weightmodellen
Phi-2: de verrassende kracht van kleine taalmodellen | Microsoft Research
stabilityai/StableBeluga-7B · Hugging Face
GitHub, salesforce/xgen: opensource-LLM’s van Salesforce met een sequentielengte van 8k.
hfl/chinese-alpaca-2-7b · Hugging Face
De toekomst van SLM’s ziet er veelbelovend uit. Ze stellen bedrijven in staat hun productiviteit te verbeteren en zijn door hun omvang eenvoudiger te trainen en te bewaken. Als je met domeinspecifieke data traint, kunnen SLM’s nauwkeuriger en efficiënter zijn.
Hier is een fascinerende casestudy van het Phi-2-team bij Microsoft Research:
Kortom, verschillende ontwikkelingen stimuleren de opkomst van SLM’s: de behoefte aan efficiëntere en betaalbaardere modellen, maar ook de wens om AI-systemen toegankelijker en beter begrijpelijk te maken. Bij MvR Digital Workforce wilden we deze kleinere, meer gespecialiseerde modellen inzetten om klanten te helpen nieuwe technologie zo efficiënt mogelijk te benutten.