Dit artikel is een vervolg op mijn eerste artikel.
Nu probeer ik de tweede motor van de transformerarchitectuur uit te leggen: het neurale netwerk. Het neurale netwerk pakt een enorme uitdaging aan in ons streven naar vloeiende, wrijvingsloze interactie tussen mens en computer: “menselijke rommel”.
Volgens mij kunnen we het er allemaal over eens zijn dat we als soort nogal rommelig zijn. We gaan niet bepaald gestructureerd met onze omgeving om en hebben zeker niets wat lijkt op de logische poorten of paden van een schakeling die op silicium is geprint. Een computer is daarentegen gebouwd op een stevig fundament van wiskunde, machinecode en programmeertalen.
Om succesvol met mensen te kunnen communiceren, moet een computer de subtiliteiten van menselijke taal begrijpen. Ook moet hij structuur en patronen kunnen vinden in onze “contextloze ruis”.
Hier is een prachtige reeks films over de werking van een computer, voor wie zich wil verdiepen in hoe anders een computer is opgebouwd. Heb je een maand of twee over, dan is dit een absolute aanrader:
Bij mensen ligt het een stuk ingewikkelder. Helaas moet je misschien een leven lang studeren en er nog steeds vrede mee hebben dat je sterft zonder antwoorden te vinden. Maar voor mensen die meer van de reis dan van de bestemming genieten, is dit een geweldige reeks met filosofen en wetenschappers die praten over complexiteit en bewustzijn.
Of het nu toeval of ontwerp is, wij mensen gaan gewoon niet erg goed om met structuur. Precies daar blinken neurale netwerken in uit. Het zijn fantastische hulpmiddelen om de ongelooflijke hoeveelheden ongestructureerde data te verwerken die mensen produceren.
Terzijde voordat we doorgaan: voor iedereen die denkt dat een “neuraal” netwerk daadwerkelijk werkt als een menselijk brein, nee, dat is niet zo. Voor zover ik weet denkt niemand die in AI of neurologie werkt dat dit wel zo is.
Laten we beginnen met een alledaagse uitdaging om te laten zien hoe een neuraal netwerk onze rommel ontrafelt.
De uitdaging: familieleden taggen in een online fotoalbum, #mam en #pap.
(Gezichtsherkenning onder een andere naam.)
Dit is een heel handige functie om al die duizenden foto’s te ordenen die we dagelijks maken. Laten we beginnen.
Hier is een foto van mijn favoriete pensionado’s:
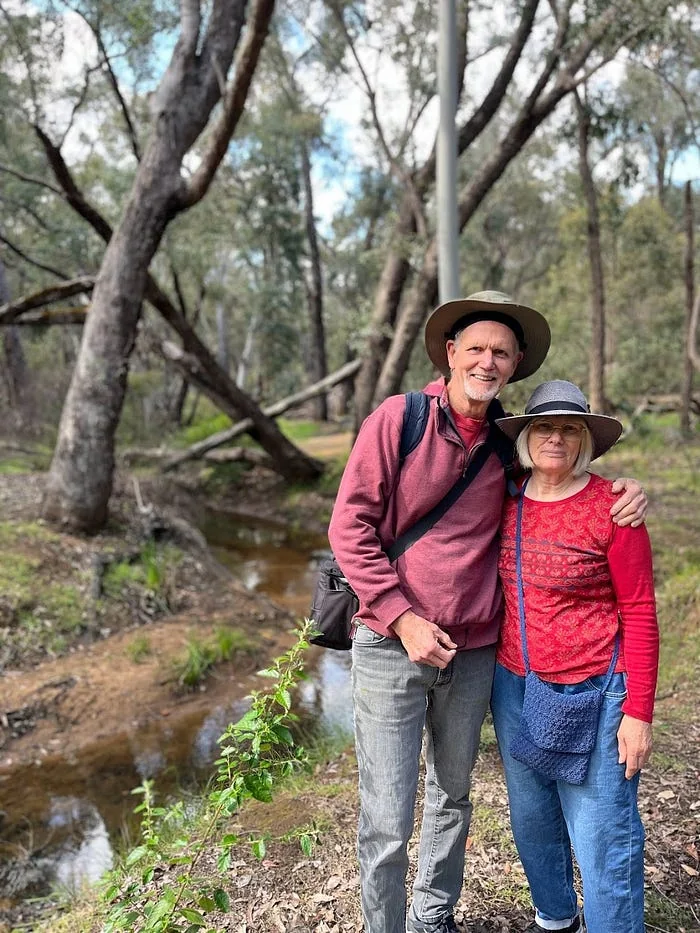
genomen in een schitterend nationaal park in West-Australië
Deze foto is gemaakt met een nieuwe iPhone. Hij heeft een hoge resolutie en HDR, en er staan veel objecten op de foto. Australische nationale parken zijn niet bepaald gestructureerde plekken. Er zijn miljoenen pixels en kleuren. Om het leven voor ons neurale netwerk nog moeilijker te maken, staan er twee mensen op die het nog nooit heeft gezien.
Het netwerk begint met menselijke hulp in te roepen. Het vraagt jou, de gebruiker, om een reeks gezichtsfoto’s te herkennen en te taggen die volgens het netwerk overeenkomen met de mensen op de foto.
Zodra je dat hebt gedaan, heeft het neurale netwerk de foto als invoer en de tags #mam en #pap als gewenste uitvoer. Nu hoeft het alleen nog te proberen de regels en representaties te leren die deze uitkomst mogelijk maakten.
Ben je technisch ingesteld, dan zijn dit een paar uitstekende video’s over het onderwerp:
https://youtu.be/HGwBXDKFk9I?si=KC6dZE75wCwRWpSu (Inleiding in de wiskunde van een CNN)
https://youtu.be/N_W4EYtsa10?si=yfpK_peYXb6148mt (Stapsgewijze uitleg over gezichtsherkenning in Python)
Voordat we doorgaan moeten we de basis definiëren, anders zijn de volgende stappen volkomen onbegrijpelijk. We moeten eerst door drie abstractieniveaus voordat we bij neurale netwerken uitkomen.
Het fantastische boek “Deep Learning with Python” van François Chollet geeft ons dit overzichtsschema:
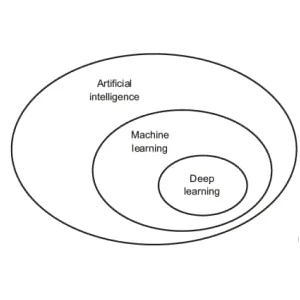
Niveau 1: kunstmatige intelligentie:
We beginnen in 1956, wanneer John McCarthy tijdens een conferentie de term “AI” gebruikt.
Ik denk daarbij altijd aan een term uit een Amerikaanse sciencefictionroman of -film uit de jaren vijftig. Dat was ook de algemene sfeer in de tweede helft van dat decennium. AI belichaamt een combinatie van techno-optimisme, “we hebben de oorlog gewonnen”, ruimtevaart en buitenaardse wezens uit Hollywood. Tegenwoordig betekent het: “een overkoepelende term voor computersoftware die menselijke cognitie nabootst om complexe taken uit te voeren en ervan te leren”.
Enkele voorbeelden van sciencefiction uit de jaren vijftig
Dit is slechts mijn bescheiden mening, maar intelligentie is een concept dat we nauwelijks begrijpen. Dat mensen vloeiend met een computer kunnen communiceren is al revolutionair genoeg.
2. Machine learning
De tweede stap in de puzzel is machine learning. Het eerste belangrijke kenmerk ervan is dat alles om data draait. Ten tweede gaat het niet om programmeren, maar om trainen. En wat trainen we? Een model dat onze data op een betekenisvolle manier omzet en zich aanpast door regels, patronen en representaties uit die data te leren.
Wat is een representatie dan? Het is gewoon een manier om naar data te kijken.
Een persoonlijk budget voor januari kan bijvoorbeeld worden weergegeven als een tabel in een Excel-sheet, grafisch als een cirkeldiagram of in audiovorm:
Machine learning is het deel van de puzzel waarmee we patronen, correlaties en waarschijnlijkheden in data vinden. Heb je voor je werk, studie of gewoon voor de lol met een datateam of grote hoeveelheden data gewerkt, dan is de kans groot dat je machine learning hebt gebruikt. Het is ook uitstekend in het doorzoeken van enorme hoeveelheden “menselijke rommel” om patronen te vinden die wij nooit zouden kunnen ontdekken.
3. Deep learning (diep neuraal netwerk):
Wil je de onderliggende wiskunde bekijken, dan zijn deze YouTube-films legendarisch.
Wil je dat niet, laten we dan beginnen :) Zo wordt een diep neuraal netwerk in duizenden studieboeken getekend:
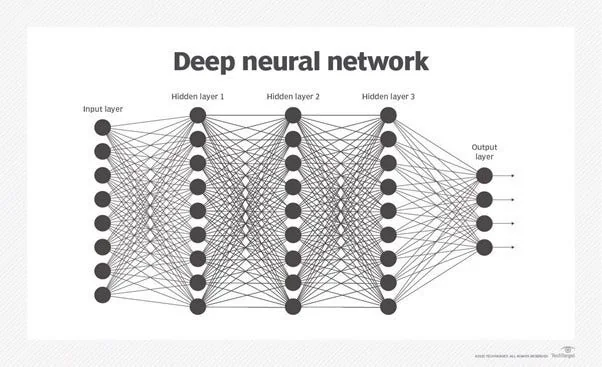
Om te beginnen hebben we drie soorten lagen:
- Invoerlaag: de laag die de invoerdata ontvangt.
- Verborgen laag: dit kunnen één of meerdere lagen zijn die berekeningen op de data uitvoeren. Zo leert iedere laag haar invoerdata om te zetten in een iets abstractere en meer samengestelde representatie.
- Uitvoerlaag: levert de uiteindelijke voorspelling. Hier begint classificatie of backpropagation.
Neuronen: de stippen. Dit zijn de kleine verwerkingseenheden van ons netwerk. Ze voeren de berekeningen uit en helpen beslissen of een stukje data door mag naar de volgende laag.
Gewichten: de lijnen. Die bepalen hoe sterk en in welke richting het ene neuron het andere beïnvloedt.
Het woord “diep” verwijst naar de doorgang van informatie door de lagen van het neurale netwerk.
Het woord “leren” is een combinatie van twee processen:
- Activatie: informatie mag door naar de volgende laag van het netwerk. De informatie wordt waardevol geacht en mag het uiteindelijke resultaat van het netwerk beïnvloeden.
- Backpropagation: het aanpassen van een gewicht, een lijn, op basis van de fout in de uitvoer. Het netwerk berekent de fout op basis van de waarde van de gewenste uitvoer en de door het netwerk berekende uitvoer. Vervolgens gaat het netwerk achteruit, van uitvoer terug naar invoer, en past het de gewichten aan om de foutmarge te verkleinen.
Begrijp je het? Goed, dan gaan we terug naar onze foto en proberen we de gezichten met het netwerk te herkennen.
Laag 1: we beginnen door iedere pixel rond de gezichten op de foto om te zetten in een getal op een raster. Ik sla bounding boxes en CNN’s over, en dan bedoel ik niet de nieuwszender. Dit is een niet-technisch voorbeeld op hoofdlijnen.
Heb je ooit zo’n pixelart-kleurboek gezien dat managers gebruiken om een burn-out te voorkomen? Ongeveer zo wil het netwerk de afbeelding zien. We gaan van een foto naar pixels en vervolgens naar getallen.
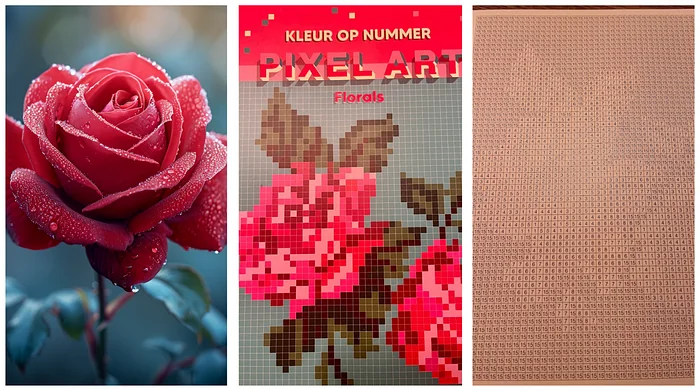
Waarop zijn die getallen gebaseerd? Dat kan van alles zijn, maar laten we nu zeggen dat het een grijstint is, iets tussen zwart en wit.
0 is wit of niets
0,1 is lichtgrijs
0,2 is grijs
0,3 is donkerder grijs
Blablabla
1 is zwart
Zodra we de getallen hebben, stapelen we ze verticaal en hebben we officieel onze eerste laag.
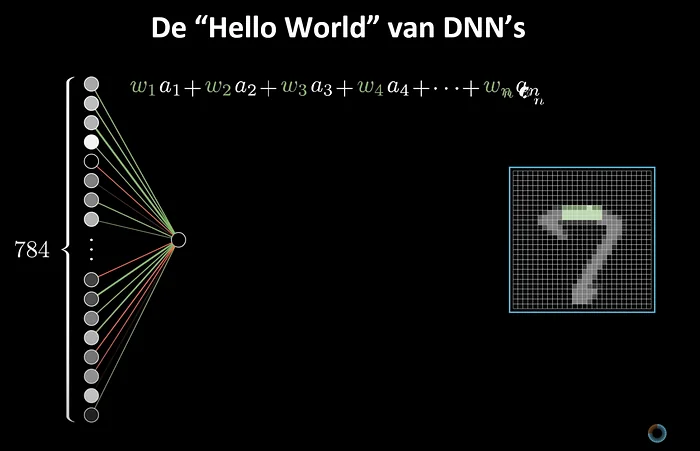
(Voorbeeld: MNIST. Dit is niet de toepassing die we hier bouwen, maar het maakt die eerste stap wel zichtbaar.)
Laag 2: zoekt naar combinaties van zwarte pixels of donkere getallen naast witte of lichte pixels. Voor de kunststudenten onder ons gaat dit om positieve en negatieve ruimte. Samen kunnen die pixels de rand van een object vormen.
- Als de waarde in het neuron 0 is, negeert het netwerk die en concentreert het zich op andere getallen.
Zodra we de randen van objecten hebben, beginnen we in al die getallen het begin van een patroon te zien.
Laag 3: zoekt vormen op het raster, zoals een lijn of een bocht. Stel je deze laag voor alsof je Zeeslag speelt. Vakjes 5a tot en met 10a hebben allemaal dezelfde of een sterk vergelijkbare kleurwaarde. Het lijkt wel een lijn! Je hebt mijn kruiser tot zinken gebracht.
- Als de waarde van de pixel lager is dan 0,01, negeert het netwerk die en concentreert het zich op andere getallen.
Nu hebben we niet alleen de randen en contouren van objecten, maar ook vormen, lijnen en bochten.
Laag 4: kan nog een stap verder gaan. De pixels, randen en lijnen worden gecombineerd tot complexere representaties van een neus, ogen, mond enzovoort. Deze geavanceerdere combinaties van getallen op een raster komen dicht bij de verwachte combinatie. Na vier stappen kunnen we ons netwerk daarom testen tegen de uitvoerlaag.
De uitvoerlaag bevat een foto die door ons is getagd en kent het resultaat dus al. Dit is een van de belangrijkste kenmerken van machine learning en deep learning: we geven het model invoer en de gewenste uitvoer; we trainen het in plaats van het te programmeren. De laag vergelijkt vervolgens de numerieke patronen van die uitvoer met wat het netwerk dacht dat de invoerfoto was. Hoe dichtbij kwam het? 30 procent, 60 procent? Dat is niet goed genoeg. We klikken op het duimpje omlaag en vervloeken de beperkingen van AI. Laten we teruggaan, een paar van die gewichten en bias-termen aanpassen en kijken of we de score kunnen verbeteren. Daarna doen we het nog een keer, en nog een keer.
Wanneer mensen het hebben over het trainen van een neuraal netwerk, bedoelen ze dit heen-en-weer rekenen, bijstellen en verwerken van menselijke feedback.
Ik weet dat het neurale netwerk van mijn foto-app werkt wanneer het foto’s van mijn ouders kan bekijken die het nooit eerder heeft gezien en ze met succes kan taggen.
Hopelijk heb je nu een globaal beeld van een eenvoudig neuraal netwerk en van de manier waarop informatie voorwaarts door de lagen beweegt en vervolgens weer teruggaat, waarbij het netwerk zich blijft aanpassen tot het uiteindelijk goed zit. Deze gelaagde architectuur werkt heel goed met menselijke rommel. Iedere stap brengt het netwerk dichter bij de structuur die het nodig heeft om efficiënt te kunnen rekenen.
Wat is nu dat feedforwardnetwerk dat in al die matroesjka-achtige black boxes van een transformerarchitectuur werkt?
Doe eens een gok. Inderdaad, het gaat niet achteruit. Het is een vooraf getraind netwerk en hoeft dus niet heen en weer te bewegen om tot het juiste antwoord te komen. Het pakt de embedding op en duwt die door paden die tijdens de training van het model zijn bepaald.
Welke paden dat zijn en waarom leg ik in het volgende hoofdstuk uit :-)
Ik hoop dat dit duidelijk was. Laat het me weten als je vragen of opmerkingen hebt!
Bedankt voor het lezen,
Kai