Het is een treurig feit dat computers mensen gewoon niet begrijpen.
Al meer dan zeventig jaar leren wij mensen omgaan met de beperkingen van computers. Daarvoor gebruiken we een muis, toetsenbord, touchscreen of trackpad, of nog erger: PowerPoint. Allemaal omdat we een computer niet gewoon kunnen vertellen wat we willen en verwachten dat die ons begrijpt.
Daar komt het transformermodel om de hoek kijken. Dankzij dit baanbrekende model begint de computer daadwerkelijk te begrijpen wat we bedoelen. Als je erover nadenkt is dat nogal wat.
Ik ga proberen de eerste stappen van dit proces uit te leggen. Mijn missie is om het zo begrijpelijk mogelijk te maken.
Het begint allemaal met een model.
Als we tegenwoordig over kunstmatige intelligentie praten, hebben we het bijna altijd over een “model”.
Een model lijkt op een vereenvoudigde kaart of een schema dat iets uit de werkelijke wereld met wiskunde beschrijft. Het helpt ons begrijpen hoe dingen werken, zien hoe verschillende onderdelen elkaar beïnvloeden en voorspellen wat er vervolgens kan gebeuren.
Een beroemd voorbeeld komt van Galileo Galilei (1564-1642).
Hij botste onder meer met de kerk over het idee dat de aarde dagelijks om haar as en rond de zon draait.
Plaats hier een flauwe grap over ballen
Volgens het beroemde, al is het historisch betwiste verhaal liet Galileo twee kanonskogels van de Scheve Toren van Pisa vallen. De ene was groter dan de andere. Hij wilde laten zien dat beide kogels vanaf dezelfde hoogte vrijwel tegelijk de grond zouden raken. En wat denk je? Hij had gelijk. Nadat hij heel wat ballen had laten vallen, en het blijft moeilijk om slechte grappen te vermijden, kon hij een model formuleren waarmee de uitkomst vanaf allerlei hoogtes te berekenen was. Zo hoefde hij niet iedere dag al dat lood de trappen van Pisa op te dragen. Dat soort modellen hielp ons uiteindelijk bij alles van auto’s en bemande ruimtevaart tot mijn mede-Australiërs die voor YouTube-likes zware spullen van gebouwen laten vallen.
Leuk weetje: in 1971 liet astronaut David Scott op de maan een veer en een hamer vallen om nogmaals te bewijzen dat het model van Galileo klopte.
Is ChatGPT een model? Niet precies. ChatGPT is de naam van een product dat gebruikmaakt van een GPT-model.
Onder de interface draait een neuraal netwerk dat is gebouwd volgens de transformerarchitectuur. Het zijn dus geen twee losse modellen, maar twee manieren om naar hetzelfde systeem te kijken:
de transformerarchitectuur bepaalt hoe informatie door het model wordt verwerkt:
de transformer.
het geheel bestaat uit een groot neuraal netwerk:
het neurale netwerk.
Midjourney levert weer fraai werk
Een kanttekening en een bonusfeitje: we noemen een model een black box wanneer we niet volledig kunnen uitleggen hoe het intern tot iedere uitkomst komt. Grote neurale netwerken zijn in die zin black-boxmodellen. Zelfs grondig onderzoek geeft niet op alle vragen een helder antwoord. Geen zorgen: ik blijf op hoofdlijnen en gebruik metaforen als kaarten en cocktailparty’s.
Wat doet een transformer?
Het model verwerkt menselijke taal in context.
Dat klinkt misschien heel eenvoudig, maar geloof me: dat is het niet.
Computers zijn veel beter dan wij als het om cijfers gaat. Elk kind dat ooit een rekenmachine heeft gebruikt weet dat. Tegelijkertijd zijn computers verschrikkelijk slecht in gewone, alledaagse taal. Iedereen die Siri of Alexa heeft gebruikt weet dat ook. Raad eens wat de eerste stap in ons transformermodel is?
1. Woorden in getallen veranderen!
Laten we beginnen met een vreemde, typisch menselijke vraag aan de transformer:
“Natuurlijk lost ijs al je levensproblemen op. Kun je me vertellen welke smaak het beste is om al mijn problemen op te lossen?”
Dit is natuurlijk een dwaze vraag. Voor mensen is het eenvoudig te begrijpen dat deze zin uitnodigt tot een vervolgvraag: “Wat voor problemen heb je?” Of: “Ga weg, mafkees.” Onze hersenen zijn getraind door onze ouders, school, boeken, films en talloze interacties met andere mensen. We hebben niet altijd logica en structuur nodig, we “snappen” het gewoon.
De transformer moet eerst rekken en opwarmen voordat hij deze opzettelijk vage vraag kan aanpakken. Het eerste wat hij doet is de woorden opdelen en in unieke getallen veranderen. Zo ziet dat eruit:

Uit de tokenteller van OpenAI, erg handig
Nu de computer getallen heeft waar hij zijn tanden in kan zetten, zijn we bijna klaar voor het model. Zo ziet de zin eruit voor ChatGPT:
[49314, 11, 10054, 12932, 68577, 682, 315, 2324, 596, 5435]
(Let op: deze getallen vertellen het model nog niet echt iets. Ze zijn slechts een beginpunt.)
Meer informatie: het model is niet zomaar een lege doos die op invoer wacht. Net als wij mensen is het getraind en heeft het zijn eigen bibliotheek met getallen.
(ChatGPT = “Generative Pre-Trained Transformer”)
Het model koppelt deze tokens aan numerieke representaties die het tijdens de training heeft geleerd. Ook de positie van ieder token in de zin wordt vastgelegd. Dat is belangrijke informatie, want het is ‘roomijs’ en niet ‘ijsroom’.
Terzijde: de Global Language Monitor stelt dat de Engelse taal meer dan een miljoen woorden telt als je alle technische, wetenschappelijke en straattaal meetelt. Nogmaals, zelfs met de getallen is dit voor de transformer geen eenvoudige uitdaging.
En hoe berekenen we eigenlijk hoe dicht bepaalde woorden bij elkaar liggen? Ik ga hier snel doorheen, maar op de achtergrond worden enorme hoeveelheden data verwerkt met grafieken zoals deze:
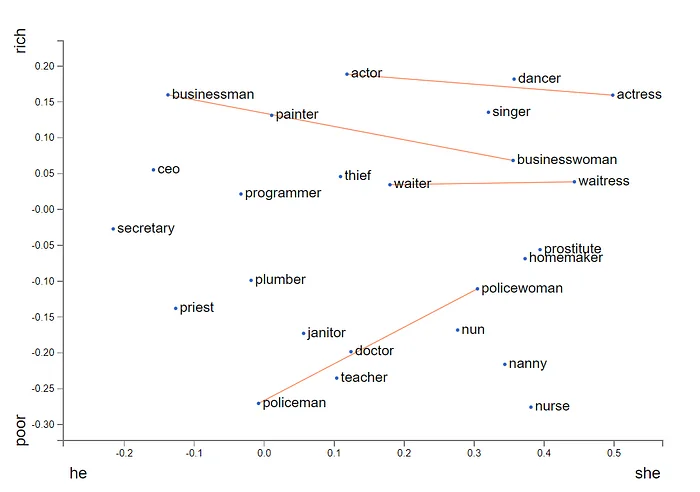
(Wanneer mensen praten over racisme, seksisme en genderbias in AI-modellen, begint het hier. Bewijsstuk A.)
Hier zijn een paar handige links met meer informatie en demo’s:
- Ontdek woordanalogieën (lamyiowce.github.io)
- Begrippenlijst voor deep learning: woord-embeddings | door Jaron Collis | Deeper Learning | Medium
- De verbazingwekkende kracht van woordvectoren | The Morning Paper (acolyer.org)
- koning min man plus vrouw is koningin, maar waarom? Piotr Migdał (migdal.pl)
De token-ID’s worden dus omgezet in embeddings: getallenreeksen die tijdens de training zijn geleerd. Daar wordt informatie over de positie in de zin aan toegevoegd. Gewapend met een flinke verzameling getallen zijn we klaar om nog dieper het konijnenhol in te gaan.
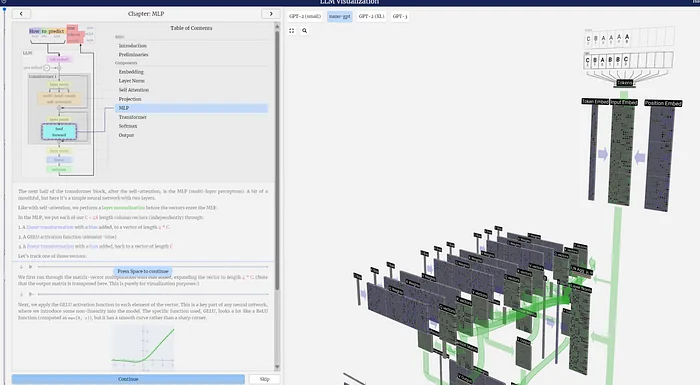
Als je niet van eenvoudig houdt: graag gedaan.
Hier is een geweldige interactieve demo van het konijnenhol: LLM-visualisatie (bbycroft.net)
2. Wat zit er in de black box?
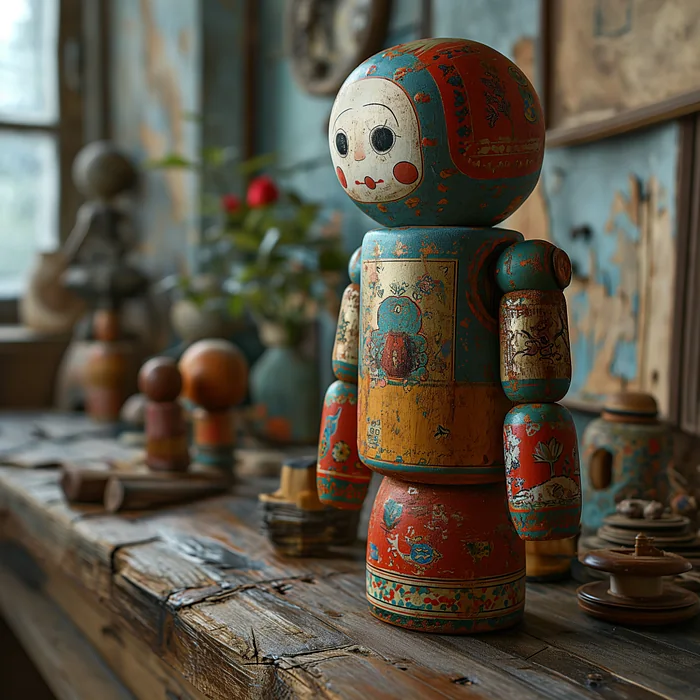
Een transformer lijkt op een matroesjkapop. Hij bestaat uit meerdere dozen, die elk zijn gevuld met kleinere modellen. Die zijn allemaal ingericht en getraind om de transformer te helpen begrijpen hoe belangrijk “ijs” in onze zin is.
Vanaf hier is alles wiskunde, maar opnieuw ga ik mijn best doen het in eenvoudige termen uit te leggen.
De transformer werkt nu niet meer met woorden, maar met lange reeksen grotere en kleinere waarden. Tijdens de verwerking worden die waarden op verschillende momenten genormaliseerd. Dat betekent niet simpelweg dat er een gemiddelde wordt genomen: de schaal wordt aangepast zodat de berekeningen stabiel en efficiënt blijven.
De eerste stap of doos in de transformerarchitectuur neemt ieder woord en analyseert het op drie manieren:
(In de praktijk betekent dit vooral: matrixvermenigvuldigingen uitvoeren met geleerde gewichten en bias-termen.)
- Query
- Key
- Value
Om uit te leggen wat die doen, gebruik ik de metafoor van een cocktailparty.
Probleemstelling: stel je voor dat je op een cocktailparty bent en iedere gast een woord in een zin voorstelt. Het doel is de context van een woord te begrijpen op basis van de andere woorden, oftewel gasten, eromheen.
Het model maakt voor ieder token een Query, Key en Value. In de metafoor betekent dat: de gasten leren kennen.
- Query: de vraag waarmee een woord bij de andere gasten langsgaat: welke informatie is voor mij relevant?
- Key: het label waarop die vraag wordt vergeleken. Het laat zien welke informatie een andere gast mogelijk te bieden heeft.
- Value: de informatie die een gast daadwerkelijk doorgeeft wanneer de Query en Key goed bij elkaar passen.
Het model vergelijkt de Queries en Keys, zet de overeenkomsten met softmax om in gewichten en maakt daarmee een gewogen combinatie van de Values. Zo bepaalt het welke andere woorden voor ieder token het belangrijkst zijn. Daarna volgen een restverbinding en normalisatie. Samen met de informatie over positie ontstaat zo een contextafhankelijke representatie van ieder woord.
Daarna gaat iedere contextafhankelijke representatie door een feedforwardnetwerk. Dat neurale netwerk voert nog meer geleerde transformaties uit voordat de volgende transformerlaag begint.
Iedere stap in de transformer heeft zijn eigen “brein” of neurale netwerk. In het volgende hoofdstuk doe ik mijn best uit te leggen hoe die werken.
3. Neuraal netwerk, wordt vervolgd
Bedankt voor het lezen,
Kai