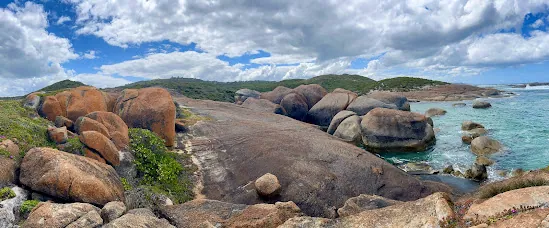
Elk jaar staan we op 22 april stil bij de Dag van de Aarde: een moment om de bijzondere planeet waarop we leven te waarderen. Mooi, toch? Ja, maar niet alleen. Voor mij werd deze editie ook een dag van bezinning op kunstmatige intelligentie en op de positieve én negatieve rol die deze technologie kan spelen in de toekomst van onze planeet en de mensheid.
Eerst een korte disclaimer: ik werk al mijn hele volwassen leven in de technologie. Tegelijkertijd ben ik, zeker als het om bossen gaat, ook een beetje een hippie. Mijn jeugd in Australië was verweven met een ruige natuurlijke schoonheid die zich nauwelijks in woorden laat vangen. In deze blogpost probeer ik drie dingen bij elkaar te brengen: mijn kennis van kunstmatige intelligentie, mijn optreden in het Discovery Museum in Kerkrade en mijn liefde voor deze grote blauwe bol.
Laten we beginnen met het grootste probleem: uitsterven. Zoals hoogleraar paleontologie Leon Claessens die avond met zijn dodoskelet liet zien, kun je de klok niet terugdraaien zodra een soort is verdwenen. Dit is geen probleem voor de sprintbacklog en al helemaal niet iets dat je met een minimaal levensvatbaar product oplost.
Ik behoor tot de denkrichting die stelt dat wij voortkomen uit een diep verweven systeem dat we nog maar ten dele begrijpen. Koert van Mensvoort, directeur van het Next Nature Museum in Eindhoven, legde dit in zijn presentatie over de geosfeer, biosfeer en technosfeer beter uit dan ik hier kan. In die zienswijze staan natuur en technologie niet los van elkaar. Ons brein, onze communicatiesystemen en ook onze tekortkomingen maken deel uit van dezelfde wereld als bomen, plankton, plastic flessen en smartphones. Dankzij wetenschap en technologie kunnen we steeds meer van die samenhang doorgronden. Toch blijven we beperkt, juist omdat we zelf onderdeel zijn van het systeem dat we proberen te begrijpen. Hoe meer we ontdekken, hoe complexer de werkelijkheid blijkt. De kwantummechanica is daarvan voor mij het duidelijkste voorbeeld: haar wetten botsen vaak met de intuïtie van ons alledaagse brein. En toch bouwen we kwantumcomputers en komen we stap voor stap verder. Hoe overbruggen we die menselijke beperkingen?
Zoals we dat al duizenden jaren doen: met gereedschap. Kunstmatige intelligentie is een uitzonderlijk krachtige uitbreiding van dat vermogen. Mijn vraag gaat niet over Ray Kurzweils singulariteit, waarin machines de mens voorbijstreven. Ik vraag me af wat er maatschappelijk gebeurt wanneer gereedschap onze waarneming, besluitvorming en invloed op de omgeving ingrijpend vergroot. En, relevanter voor de Dag van de Aarde: wat kost die sprong voorwaarts? Is de opbrengst groot genoeg om de druk op de planeet waarvan we volledig afhankelijk zijn te rechtvaardigen?
Tijdens het evenement spraken veel inspirerende mensen. Hoogleraar Felienne Hermans stelde het publiek een eenvoudige maar indringende vraag: denk aan een plek op aarde waarmee je je verbonden voelt en stel je vervolgens voor dat die voorgoed verdwijnt. Ik wist onmiddellijk welke plek dat voor mij was.
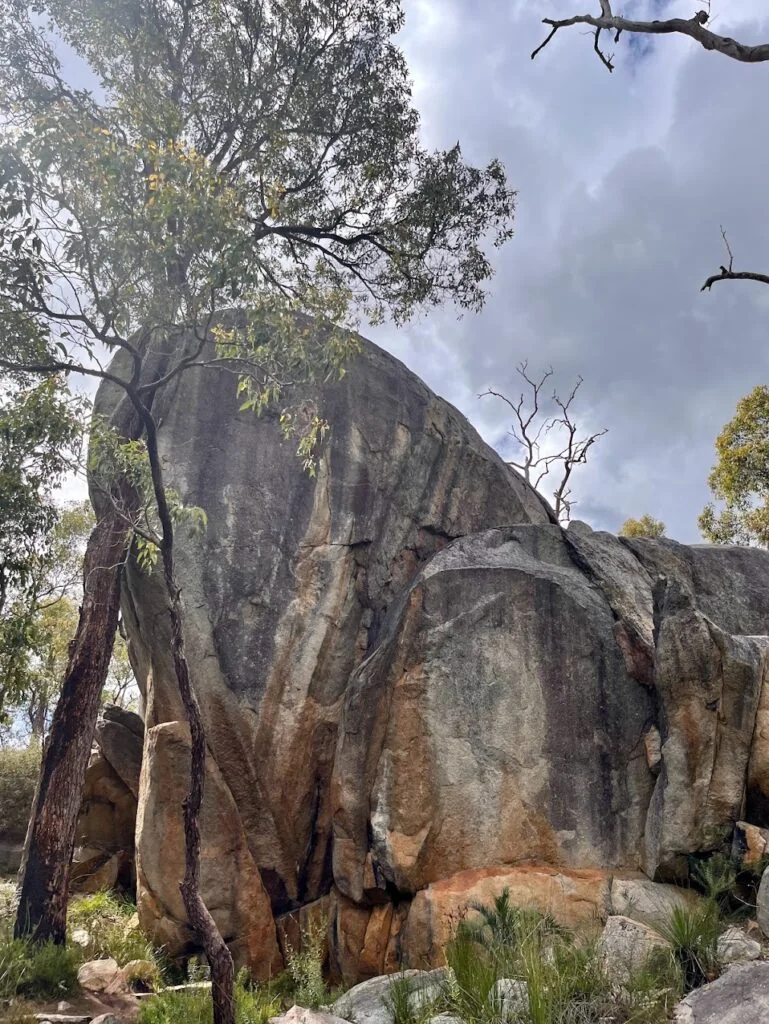
Deze eenvoudige rots in het bos was in mijn jeugd mijn veilige plek. Overdag of 's nachts trok ik de Darling Ranges in West-Australië in. Een smal, kronkelend pad leidde het dal in naar een enorm granieten rotsblok. Daar keek ik, onder een volle maan of een verzengende zomerzon, uit over de heuvelruggen. De problemen van een tiener werden klein naast dat uitzicht. Wanneer niets zeker voelde, bleef het graniet rustig en onbeweeglijk liggen, als een steen in een rivierbedding. Het droeg mij, een klein en kortlevend organisme dat nadacht over het leven, het universum en alles. Als ik ooit tot een andere vorm van materie overga, wil ik dat mijn as hier terechtkomt. De gedachte dat deze plek kan verdwijnen, vind ik afschuwelijk.
Daarom moeten we de vraag blijven stellen: is de inzet van dit krachtige gereedschap de ecologische prijs waard? Niet één keer, maar bij iedere toepassing. Iedereen die met AI werkt, draagt een deel van die afweging.
We zijn hier bovendien al eerder geweest:
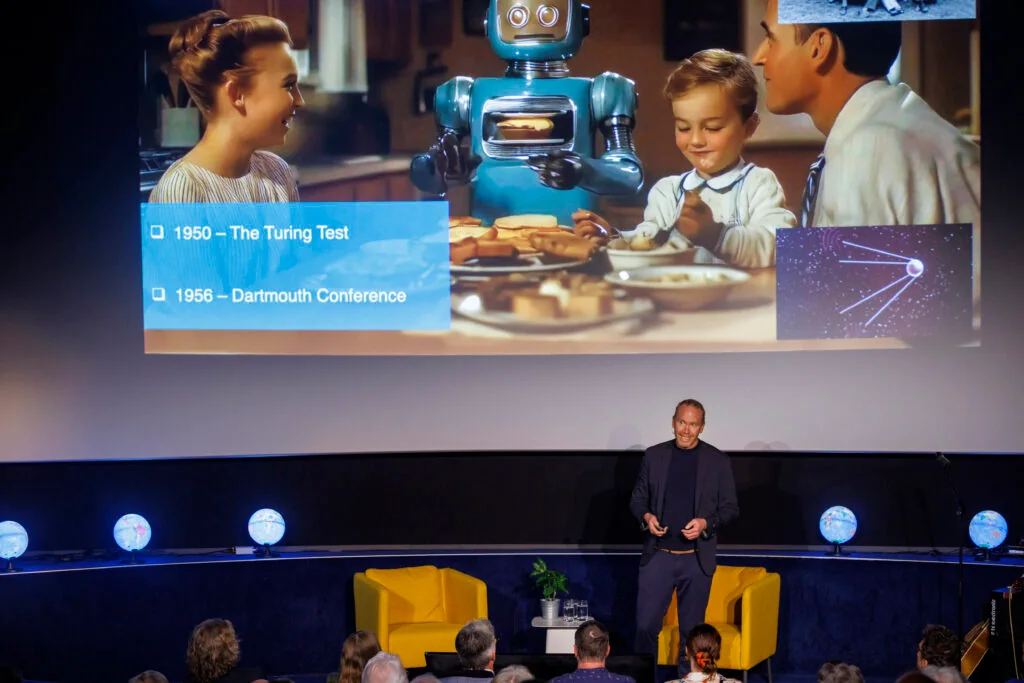
In 1950 stelde Alan Turing de beroemde vraag: 'Kunnen machines denken?' Het was geen vraag over schaalbaarheid of ecologische kosten, maar een filosofisch gedachte-experiment. Zeven jaar eerder hadden Warren McCulloch en Walter Pitts al een wiskundig model van een kunstmatig neuron beschreven. In de techno-optimistische jaren vijftig groeide het vertrouwen dat zulke ideeën uiteindelijk tot intelligente machines konden leiden. Tijdens de Dartmouth-workshop van 1956 kreeg het onderzoeksgebied zijn naam en een ambitieus programma. Sciencefictionschrijvers hoefden vervolgens niet veel verbeeldingskracht meer toe te voegen: in een tijd van televisies en Spoetnik lagen robots, ruimteschepen en maanbases ineens in het verlengde van de werkelijkheid.
Daarna botsten de beloften op de grenzen van de techniek. Minsky en Papert lieten in Perceptrons uit 1969 zien wat eenvoudige neurale netwerken niet konden. Tegelijkertijd bleken rekenkracht, data en methoden ontoereikend om de grote verwachtingen waar te maken. Financiers haakten af en het vakgebied belandde vanaf de jaren zeventig in wat later de eerste AI-winter werd genoemd; een tweede volgde eind jaren tachtig. Neurale netwerken verdwenen ondertussen niet. Onderzoekers werkten door en vanaf de jaren 2000 kwamen betere algoritmen, meer data en krachtigere hardware bij elkaar.
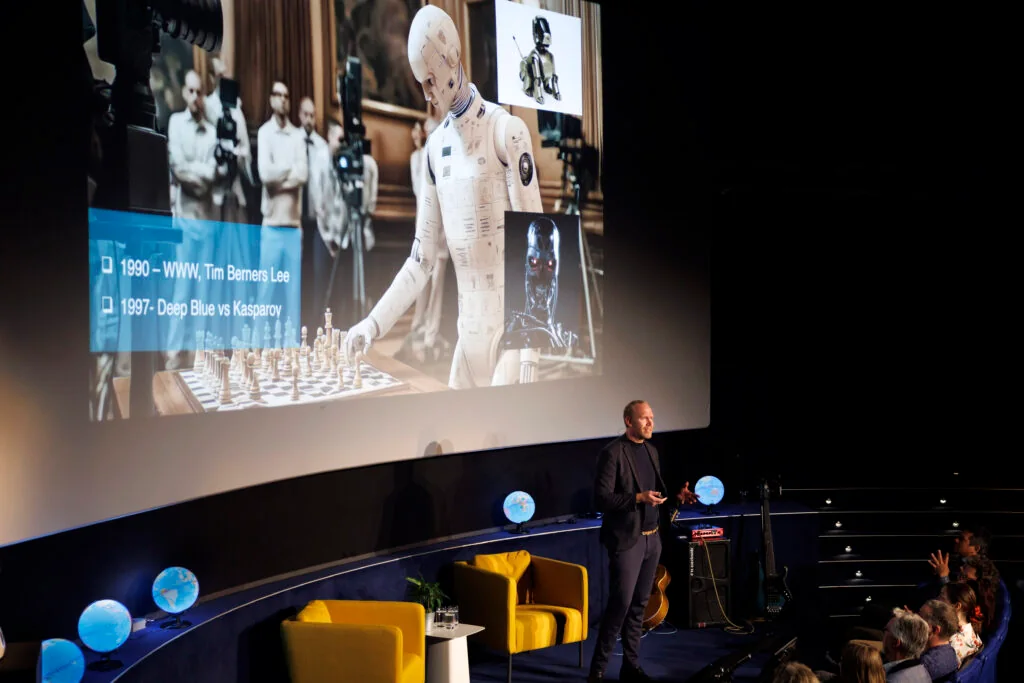
Het verhaal was dus niet voorbij. Specialistisch onderzoek naar neurale netwerken ging op de achtergrond verder. Deep learning en later grote taalmodellen konden voortbouwen op decennia aan werk, geholpen door twee onverwachte ontwikkelingen: krachtige grafische processors uit de game-industrie en de enorme hoeveelheden digitale data die het internettijdperk opleverde.
Aan het einde van de jaren negentig werden grafische processors gemeengoed. Ze bleken niet alleen geschikt om videogames te tekenen, maar ook om veel berekeningen tegelijk uit te voeren.
Dit interview over CUDA laat goed zien waarom die parallelle rekenkracht zo belangrijk werd:
Het web leverde enorme datasets op en GPU's maakten parallel rekenen steeds betaalbaarder. Samen met verbeteringen in deep learning vormde dat in de jaren 2010 de voedingsbodem voor de huidige AI-golf. Maar aan die vooruitgang hangt een prijskaartje. Grote modellen vragen veel rekenkracht, en rekenkracht vraagt energie. Hoeveel precies is lastig vast te stellen: bedrijven publiceren lang niet alle gegevens en schattingen verschillen sterk per model, datacenter en energiemix. De orde van grootte is niettemin reden genoeg om scherp te kijken.
De onderstaande cijfers geven een beeld van de stand van zaken toen ik dit artikel in april 2025 schreef. Het zijn schattingen uit verschillende bronnen, met uiteenlopende definities en onzekerheidsmarges; lees ze daarom als orde van grootte, niet als een nauwkeurige meterstand.
Voor deze inventarisatie gebruikte ik OpenAI Deep Research als zoekhulp. Ik heb de uitkomsten geselecteerd en de bronnen afzonderlijk opgenomen, juist omdat een AI-samenvatting nooit de broncontrole vervangt.
- Het gezamenlijke elektriciteitsverbruik van datacenters met AI-hardware is inmiddels vergelijkbaar met dat van middelgrote landen. (World Economic Forum: de energievraag van AI verminderen met verwerking op apparaten).
- Datacenters waren aan het begin van de jaren 2020 wereldwijd goed voor ongeveer 1 tot 2% van het elektriciteitsverbruik. (MIT Sloan: het energieverbruik van AI in datacenters). De sector werd qua energiegebruik en uitstoot geregeld met de luchtvaart vergeleken, al zijn zulke vergelijkingen sterk afhankelijk van de gekozen systeemgrenzen. (MIT Sloan). In 2022 verbruikten datacenters naar schatting 460 terawattuur (TWh). Voor 2025 werd meer dan 500 TWh voorzien, of ongeveer 2% van de wereldwijde elektriciteit. (Deloitte Insights: duurzamere datacenters). Het Internationaal Energieagentschap waarschuwde bovendien dat de wereldwijde vraag van datacenters tussen 2022 en 2026 kon verdubbelen, mede door AI. (MIT Sloan). In het hogere scenario zou dat neerkomen op enkele procenten van alle elektriciteit ter wereld. (IEA: Electricity 2024).
- In 2022 stootten datacenters en cryptomining samen bijna 1% van de wereldwijde CO₂ uit, waarvan ongeveer 0,5% alleen door datacenters. (De CO₂-uitstoot van AI en crypto stijgt, en belastingbeleid kan helpen) (De CO₂-uitstoot van AI en crypto stijgt, en belastingbeleid kan helpen). Als de trend doorzet, kan hun uitstoot in 2027 450 miljoen ton CO₂ bedragen, ongeveer 1,2% van de mondiale uitstoot. (De CO₂-uitstoot van AI en crypto stijgt, en belastingbeleid kan helpen).
- Het trainen van OpenAI's GPT-3 met 175 miljard parameters verbruikte 1.287 MWh elektriciteit en stootte ongeveer 502 ton CO₂ uit. (De groeiende CO₂-voetafdruk van AI | State of the Planet). Dat staat gelijk aan de jaarlijkse uitstoot van ongeveer 110 benzineauto's.
- Niet alleen training, maar ook dagelijks gebruik veroorzaakt uitstoot. Voor één specifiek gebruiksscenario van GPT-3 werd de voetafdruk van inferentie geschat op ongeveer 23 kilo CO₂ per dag, of 8,4 ton per jaar. Dat cijfer is geen universele waarde voor GPT-3; het illustreert vooral hoe sterk de uitkomst afhangt van gebruik, hardware en energiemix. (State of the Planet: de groeiende CO₂-voetafdruk van AI).
- Voor ChatGPT circuleerde in 2025 een schatting van ruim 260.000 kilo CO₂ per maand bij ongeveer 164 miljoen gebruikers. (De gepubliceerde schatting). De bron vergeleek dat met 260 vluchten tussen New York en Londen per maand. (Toelichting bij de vergelijking). Omdat OpenAI geen volledige energie- en emissiegegevens per dienst publiceerde, blijft zo'n berekening zeer onzeker.
- Door het snel groeiende gebruik verschoof de aandacht van de eenmalige training naar inferentie: het dagelijks draaien van de dienst en beantwoorden van enorme aantallen vragen. Google meldde dat bij zijn eigen machinelearningwerk ongeveer 60% van het energieverbruik naar inferentie ging en 40% naar training. (State of the Planet: de groeiende CO₂-voetafdruk van AI). Een model kan na ingebruikname miljoenen keren per dag worden aangeroepen. Opgeteld kan dat dagelijkse gebruik daardoor meer energie kosten dan de oorspronkelijke training.
- Een destijds veel aangehaalde schatting kwam uit op ongeveer 2,9 Wh per vraag aan ChatGPT, ruwweg tien keer het verbruik van een klassieke Google-zoekopdracht. (World Economic Forum). Zulke gemiddelden veranderen snel en verschillen per model, antwoordlengte en infrastructuur. Een scenario waarin alle dagelijkse zoekopdrachten door vergelijkbare modellen worden afgehandeld, laat vooral zien dat kleine verschillen per vraag op wereldschaal zwaar kunnen doorwegen. (RoboticsTomorrow: energiebehoefte en modelgrootte)
- In de Verenigde Staten steeg het energieverbruik van specifieke AI-hardware van slechts ongeveer 2 TWh in 2017 naar circa 40 TWh in 2023, een twintigvoudige stijging in zes jaar. (Energie van datacenters en AI in 2025, door David Mytton).
- Analisten van Gartner voorspellen dat het stroomverbruik van voor AI geoptimaliseerde datacenterservers van 2023 tot 2027 met een factor 2,6 stijgt, tot ongeveer 500 TWh per jaar in 2027. (Waarschuwingen over het energieverbruik van datacenters worden dringender | The Register).
- Het IMF schat dat datacenters, waarvan veel AI draaien, plus crypto halverwege de jaren 2020 goed kunnen zijn voor 3,5% van de wereldwijde elektriciteit, tegenover ongeveer 2% in 2022. (De CO₂-uitstoot van AI en crypto stijgt, en belastingbeleid kan helpen). Als dat werkelijkheid wordt, evenaart het het elektriciteitsverbruik van het hele Verenigd Koninkrijk.
- MIT Sloan besprak ook een zeer hoog scenario waarin het volledige systeem rond AI wordt meegerekend, inclusief ondersteunende infrastructuur. In dat scenario zou het aandeel van datacenters in de wereldwijde energievraag in 2030 21% kunnen naderen. Dit is nadrukkelijk een bovengrens, geen breed gedragen voorspelling. (MIT Sloan: het energieverbruik van AI in datacenters)
Waar gaat die energie vervolgens naartoe? In grote lijnen naar de volgende categorieën:
- Training van AI-modellen in clouddatacenters: Een enkele trainingsrun van een groot taalmodel als GPT-3 of PaLM kan naar schatting 1 tot 5 GWh elektriciteit verbruiken. Ter vergelijking: 1 GWh is ongeveer het jaarlijkse verbruik van honderd Amerikaanse huishoudens. Voor GPT-3 werd 1.287 MWh gerapporteerd. (State of the Planet: de groeiende CO₂-voetafdruk van AI). Kanttekening: zulke schattingen omvatten niet altijd alle mislukte runs, experimenten en ondersteunende infrastructuur.
- Inferentie en AI-diensten in de cloud: Na de training worden modellen ingezet in chatbots, vertaaldiensten, aanbevelingssystemen en beeldgeneratoren. Het energieverbruik groeit vervolgens mee met het aantal gebruikers en opdrachten. Google rapporteerde voor zijn eigen machinelearningwerk een verhouding van ongeveer 60% voor inferentie en 40% voor training. (State of the Planet). Diensten voor taalverwerking illustreren het schaaleffect: één opdracht kost misschien maar enkele watturen, maar miljarden opdrachten tellen op. Schattingen voor het jaarlijkse verbruik en de uitstoot van ChatGPT liepen sterk uiteen, juist doordat betrouwbare openbare meetgegevens ontbraken. (Een van de destijds gepubliceerde schattingen).
- Ook beeld- en videomodellen gebruiken voor iedere opdracht GPU-capaciteit. Zoekmachines met generatieve AI illustreren het schaaleffect: afhankelijk van model en opzet kan AI het energieverbruik per zoekvraag aanzienlijk verhogen. (World Economic Forum) (RoboticsTomorrow). Beeldgeneratie is doorgaans zwaarder dan een korte tekstbewerking, maar simpele vergelijkingen met huishoudelijke apparaten verhullen hoeveel de uitkomst per systeem verschilt.
- Aanbevelingsalgoritmen van bijvoorbeeld YouTube, Netflix en Amazon draaien eveneens in datacenters. Ze zijn vaak kleiner en sterker geoptimaliseerd dan generatieve modellen, waardoor één aanbeveling relatief weinig energie kost. Door het enorme aantal transacties vormen ze samen toch een wezenlijk deel van de inferentiewerkbelasting. Grote technologiebedrijven rapporteren dan ook een stijgend energieverbruik naarmate personalisering verder wordt uitgebreid. (State of the Planet: de groeiende CO₂-voetafdruk van AI).
Dit onderzoek vergelijkt het energieverbruik van verschillende soorten AI-taken en maakt de verschillen concreter: Power Hungry Processing: Watts Driving the Cost of AI Deployment.
Een andere spreker, hoogleraar innovatie en klimaatverandering Heleen de Coninck, sprak over 'AI-schaamte'. Als iemand die in deze sector werkt en de technologie intensief bestudeert, begrijp ik wat ze bedoelt. Dankzij New Scientist en de sprekers van die dag stel ik mezelf daarom bij ieder gebruik en iedere invoering van een AI-systeem opnieuw dezelfde vraag:
'Is dit het waard?'
Bedankt voor het lezen.
Kai
(Ik mocht die avond ook bas spelen op een nummer van Joni Mitchell. Dat was bijzonder leuk, kostte nauwelijks energie en gaf de avond hopelijk iets terug.)