Als gewone kantoormens, nullen en enen schuivend over een scherm, op wisselende tempo's en meestal aangedreven door te dure koffie, verwacht ik niet veel wowmomenten op een dag. En toch zit ik hier achter mijn computer, wat instellingen in een AI-muziekdienst aan te klikken, en: wauw. Ik bedoel: WAUW. Nee wacht, het is meer: Wauwwwwwwww.
Wat maakte me zo enthousiast? Versie 5 van het Suno-model, een generatieve AI-muziekdienst die helpt bij het schrijven en remixen van nummers en het maken van covers. Ik had het de laatste tijd te druk om dit soort technologie te verkennen, maar tijdens het doomscrollen of via muziekliefhebbende vrienden kreeg ik af en toe een AI-remix toegestuurd. Je hebt vast weleens iets vergelijkbaars gehoord, zoals deze YouTube-video waarin een grungeklassieker van Alice in Chains uit de jaren negentig verandert in soul met de sfeer van Motown uit de jaren zeventig:
Het is indrukwekkend, grappig en vreemd tegelijk, maar nog altijd niet meer dan een korte afleiding en van beperkte artistieke waarde. Een jaar geleden probeerde ik versie 3.5 van deze dienst en die was werkelijk afschuwelijk. Zelfs onluisterbaar. Pianoakkoorden werden zo op elkaar gepropt dat het klonk alsof de pianist in slaap was gevallen met zijn voet op het sustainpedaal, nadat hij drie minuten lang willekeurige noten had aangeslagen. Beats die rechtstreeks uit de porno-industrie leken te komen, werden in de mix gekwakt. En ergens in dit tonale moeras krijste een synthetische stem, die Auto-Tune deed klinken als Emma Kirkby, met vlakke intonatie: 'Ik ben een AI-model, maar ik heb ook gevoelens'.
Ik sloot de browser en zwoer dat ik mezelf nooit meer aan zo'n auditieve marteling zou onderwerpen.
In de herfst van 2025 was er veel veranderd. Muzikanten zoals MonoNeon jamden mee met achtergrondtracks van Suno. Vrienden bleven zeggen: 'Man, je moet dit proberen'... en ja, yachtrockremixen waren overal.
Blijkbaar houd ik van afzien, want ik logde in op de Suno-site, gooide tien euro in de gokautomaat van het nieuwste generatieve muziekmodel en trok aan de hendel. https://suno.com/
Mijn reactie kwam, zonder overdrijving, heel dicht bij pure creatieve vreugde.
De afgelopen avonden heb ik onvoltooide muziekschetsen gepakt die ik lang geleden schreef en Suno gevraagd om instrumenten toe te voegen die ik niet kan bespelen, me een creatieve richting op te sturen die ik zelf nooit had overwogen en compleet nieuwe secties te componeren die coherent aansluiten op mijn oorspronkelijke ideeën.
Het effect? 'Wauw', ik bedoel 'WAUW'. Nee wacht, het is nog steeds: 'Wauwwwwwwww'.
De kunst is van de fantastische maker: https://superrare.com/grif
Een korte uitleg van hoe ik Suno gebruik:
Mijn workflow is eenvoudig, maar het echte plezier ontstaat wanneer ik meespeel met onverwachte geluiden, beats en compositorische structuren die Suno genereert. En eerlijk gezegd denk ik dat dit proces ook bruikbaar is buiten de muziek.
Laten we beginnen met de verwachtingen: ik vraag Suno niet om een compleet nummer voor mij te schrijven. Ik speel al ruim dertig jaar muziek, heb muziek gestudeerd en treed nog steeds op met bands. Suno is een hulpmiddel, geen artiest of entiteit. Al het gepraat over een 'intelligente assistent' is pure marketingpraat.
Kanttekening: De Nederlandse meesterbassist Theo de Jong beschrijft de rol van het gereedschap in het creatieve proces perfect in deze video:
Dit uitgangspunt geldt voor vrijwel elke generatieve AI-taak die je kunt bedenken. ChatGPT, Gemini of <vul hier een willekeurige LLM-naam in> zijn niet je accountant, therapeut, persoonlijk assistent en schrijfcoach in één. Natuurlijk voeren deze systemen genoeg taken uit die eruitzien alsof ze dat wel zijn. Maar je hebt enige basiskennis nodig om ze werkelijk nuttig in te zetten.
Anders navigeer je op basis van willekeurige antwoorden door het leven, met ongeveer evenveel kans op een goede als op een slechte afloop.
Om dit concept iets formeler te maken: deze tak van machine learning heet generatieve modellering. Daarbij train je een model om nieuwe gegevens te produceren die lijken op een bestaande dataset.
Stel je bijvoorbeeld voor dat we een dataset hebben met duizenden opnamen van composities van Bach. We kunnen een 'Suno-achtig' generatief model op Bach trainen om de regels te leren die de complexe relaties bepalen tussen nootfrequenties, de stiltes tussen klanken en de manier waarop zijn stukken worden uitgevoerd. Door die regels te modelleren kunnen we, in theorie althans, een nieuwe Bach-achtige compositie maken, iets dat niet in de oorspronkelijke dataset of in het hoofd van deze halfgod van de moderne muziek bestond.
Maar let goed op het woord 'achtig' in die zin, want daarin zit een stevige disclaimer verstopt. Het machinelearningalgoritme, of 'AI' als je dat liever zegt, is niet creatief. Het herkent simpelweg statistische correlaties en patronen en reproduceert die als nieuwe gegevens.
Sommige mensen, die veel slimmer zijn dan ik ooit zal zijn, stellen dat machinelearningmodellen patronen kunnen herkennen die het menselijk vermogen overstijgen. Anderen, die net zo briljant zijn, brengen daartegenin dat mensen patronen kunnen waarnemen die geen enkele machine kan evenaren.
Laten we dat debat helemaal overslaan en muziek gaan maken.
Nu de verwachtingen en definities uit de weg zijn, gaan we door naar stap 2:
Het idee.
Mijn eerste poging met Suno was niet zomaar een vaag idee. Ik had akkoorden, een baslijn, een melodie en alle structurele basiselementen van een nummer. Ik heb lang geleden geleerd dat intentie een cruciaal onderdeel is van elk creatief proces, en dat lijkt net zo essentieel wanneer je met een generatief model werkt.
AI, in welke vorm dan ook, gedijt bij duidelijkheid. Als je nog niet weet welk resultaat je wilt, kun je beter eerst je vraag verbreden. Vraag het model bijvoorbeeld om tien verschillende ideeën, verken de mogelijkheden, bepaal wat je aanspreekt, schrijf dat op en keer daarmee terug voor de volgende stap.
Hier is een voorbeeld van een baslijn en enkele elementen van een nummer dat ik lang geleden schetste, maar nooit echt afmaakte.
Ik werkte het idee tot een bepaald punt uit en bewaarde het online voor later. Je hoort duidelijk dat hier een bassist een nummer schrijft, en dan ook nog de versie van mij van tien jaar geleden. De hele track leunt zwaar op één centrale baslijn. De andere ideeën bestaan vooral uit gekopieerde samples en een paar synthlijnen; creatief wegen ze niet op tegen dat ene dominante baselement.
Mijn ambitie met deze schets was destijds om het volgende te maken:
- Een Larry Graham-sfeer uit de jaren zeventig
- Een jazzfusioncompositie voor bigband of orkest
- Een groove waarop mensen met hun hoofd gaan knikken (en misschien nog wel meer)
Helaas strandde het nummer ergens tussen mijn creativiteit, vaardigheden en tijdmanagement. Ik ben blij met wat ik heb, maar ik heb geen idee hoe ik voor een bigband of orkest moet schrijven. Als ik wil dat een gitarist of drummer de partij in mijn hoofd speelt, moet ik die neuriën of zingen. Daardoor gaat er veel verloren in de vertaling. Dat is niet per se slecht, want het schept ruimte voor interpretatie en de creativiteit van anderen. Toch liep ik als bassist tegen een muur.
Zodra ik mijn intenties op hoofdlijnen heb bepaald, is de volgende stap om van concept naar arrangement in te zoomen, tot op het niveau van afzonderlijke instrumenten. Ik heb muzikanten nodig. Ik moet als bandleider met hen communiceren. Dat betekent dat ik de partijen voor elk instrument moet uitleggen of uitschrijven, de bouwstenen moet neerleggen en tegelijk een gevoel van continuïteit en visie moet behouden.
Om je een beeld te geven van wat ik voor de instrumentale arrangementen in gedachten had:
Drums: Speel een stevige, dansbare groove die de baslijn aanvult zonder met een druk bassdrumpatroon te botsen. Houd het stabiel en blijf uit de weg van het kernritme dat de bas neerzet.
Strijkers: Ik wil zwevende strijkers in die klassieke orkestrale funkstijl uit de jaren zeventig, met de sfeer van The Love Boat. Legatolijnen die mijn korte synthopnamen volgen.
Blazers: Ze moeten functioneren als onderdeel van de ritmesectie. Gebruik de hoofdgroove als begeleidende lijn die naar een crescendo toewerkt, afgesloten door een saxofoonsolo.
Elk van deze instructies is subjectief, maar wel gebaseerd op mijn ervaring als muzikant. En precies hier komt een generatief model tot zijn recht. Een ouder, discriminatief systeem zou vooral als intelligente labelaar werken. We zouden het voorbeelden en labels als 'funky', 'bas' of 'swing' geven, waarna het gaandeweg leerde om die labels aan nieuwe data toe te kennen.
Wanneer ik dus zeg: 'Ik wil dat de gitarist een percussieve funklijn in zestiende noten speelt in G mineur', verwijst elk deel van die zin naar gegevens die het model heeft gezien. Het zou vervolgens bijpassende samples uit een bibliotheek kunnen ophalen. Dat is nuttig, maar mijn verzoek is zo complex dat het materiaal over meerdere variabelen moet worden aangepast. Hier neemt generatieve modellering het over.
Generatieve modellen kunnen veel fijnmaziger patronen in dezelfde data modelleren. Om nieuwe klanken te genereren die aan mijn eisen voldoen, moet het systeem verbanden leren tussen de kleinste bouwstenen van klank, mijn 'sonische pixels'. Het kan niet stoppen bij categorieën op hoofdlijnen en me alleen een kant-en-klare sample geven die wel of niet in mijn arrangement past.
Het muziekmaakproces stopt hier niet. Zodra ik deze elementen 'op band' vastleg, oftewel opneem, moet ik ook nadenken over hoe ik wil dat de uiteindelijke opname klinkt. Een referentietrack gebruiken is vaak de gemakkelijkste manier om die richting te bepalen. In dit stadium is het net zo belangrijk om te weten wat ik niet in de opname wil als wat ik wel wil.
Als geluidstechnicus wil ik:
- Dat de mix groot klinkt. Dit is orkestrale funk uit de jaren zeventig.
- Dat de bas strak en gecomprimeerd klinkt.
- Galm, maar niet te veel.
Nu ik wat tijd heb besteed aan het bepalen van wat ik wil dat Suno doet, heb ik alle ingrediënten voor een stevige samenwerking met AI.
Ik heb zelf een muziekschets geschreven, dus het is niet alleen de AI die op basis van trainingsdata achtergrondmuzak genereert.
Samen geven mijn schets en instructies het model een duidelijke route naar een resultaat met helder omschreven eisen.
Met die basis op zijn plaats upload ik de track naar Suno en gebruik ik de functie 'Cover'.
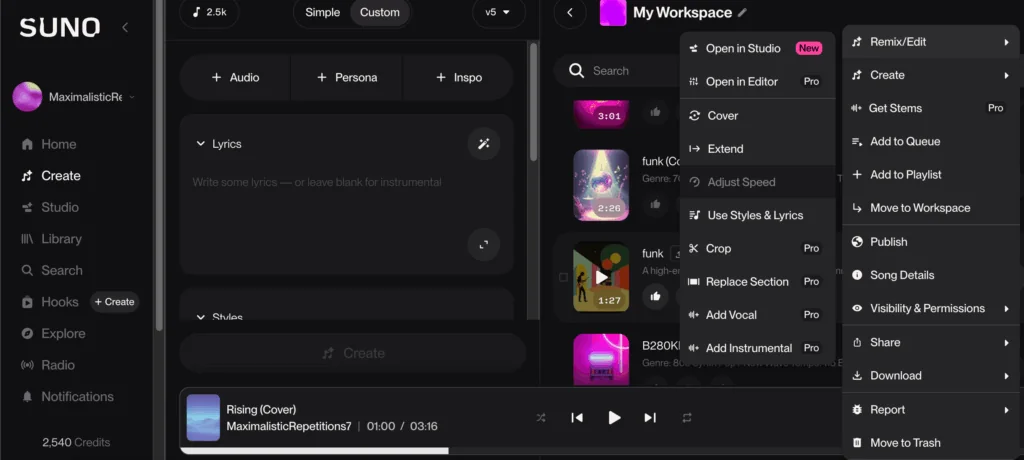
Nu moet ik met de machine praten. Dit is mijn prompt:
Genre: funk uit de jaren zeventig / jazzfunk / orkestrale funk
Tempo: 105 BPM
Stemming: rauw, krachtig, energiek, vuile groove
Instrumenten: volledige blazerssectie (trompetten, trombones, saxofoon), weelderige discostrijkers, clavinet, wah-gitaar, elektrische piano, funky bas, strak drumstel, conga's, saxofoonsolo's
Details: Stevige funk uit de jaren zeventig met dikke blazersriffs, gesyncopeerde ritmegitaar, slapbas en funkbas, orkestrale accenten van strijkers en vuile jazzsolo's. Denk aan bigbandfunk: energiek, rauw, zweterig en filmisch.
Uitgesloten stijlen: zware galm, synthesizers, EDM-drums, zang met Auto-Tune
Als ik een track remix die ik al heb geschreven, wil ik het model niet vragen om iets te herstructureren. Maar als er iets ontbreekt, als ik niet geïnspireerd was of als ik nieuwe structurele ideeën wil verkennen, kan ik de opbouw van de remix doelbewuster vastleggen, zoals hier:
Structuur: intro (drums + blazers) → couplet (groove + ritmesectie) → refrein (accenten van de hele band) → bridge (blazerssolo's) → slotrefrein (grote funkexplosie)
En dertig seconden later genereerde het dit:
Vanaf hier heb ik een volgende versie van mijn schets. Ik vind hem geweldig, maar goede god, wat is hij cheesy. Bovendien zijn de compressieartefacten zo duidelijk hoorbaar dat ik deze uitvoer opnieuw moet bewerken. En voorlopig ben ik nog altijd een betere bassist dan Suno.
De volgende stap is de AI-audioschets opsplitsen in afzonderlijke tracks. Dat kan in Logic Pro, in Suno zelf of met apps van derden. Mijn ervaring is dat de ingebouwde splitter van Suno het schoonste resultaat geeft.
Welke tool je ook gebruikt, bij het splitsen ontstaan artefacten en kunnen transiënten beschadigd raken. Dat is hier geen groot probleem: het blijft een schets.
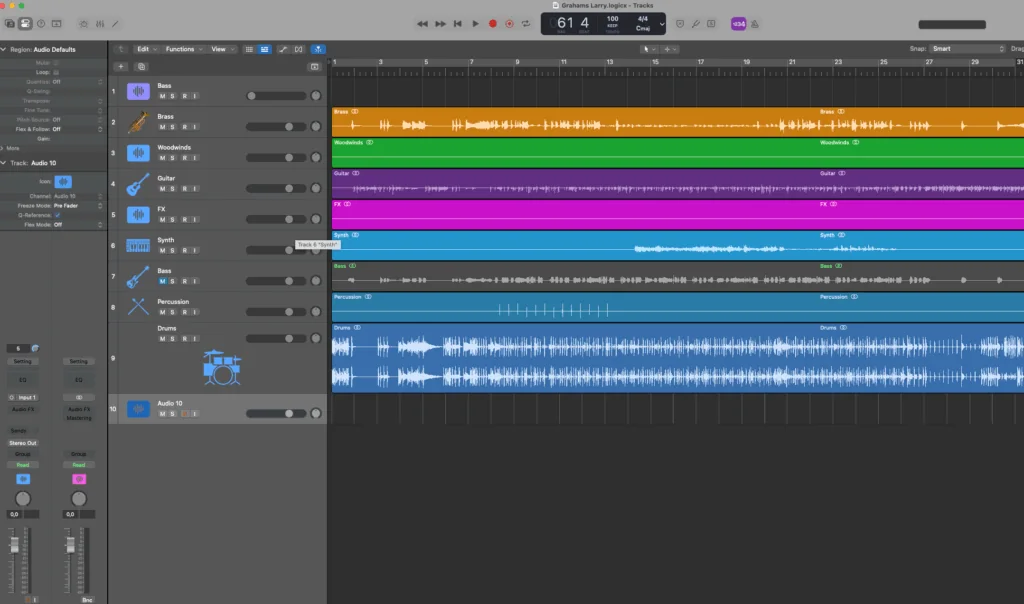
In mijn favoriete editor begin ik vervolgens tracks opnieuw op te nemen. Voor dit voorbeeld houd ik het kort en eenvoudig: ik neem alleen de bastrack opnieuw op en verwijder vreemde elementen. Suno besloot op rare momenten willekeurige blazersaccenten in mijn track te stoppen, dus die haalde ik eruit.
Mijn oorspronkelijke idee ligt ineens veel dichter bij mijn intentie. Het is gemakkelijker te arrangeren en op te nemen. Ik kan het delen met andere muzikanten, producers of vrienden voor feedback en samenwerking. En het komt een aantal stappen dichter bij wat ik bedoelde, zonder dat het me jaren studie en uren productiewerk kost. Het is nog niet klaar voor uitgave, maar het is een ruwe opname met meerdere instrumenten die mijn creatieve bereik vergroot en me helpt mijn ideeën de wereld in te brengen.
Dankzij AI werk ik in zekere zin als muziekproducent. Ik definieer en stuur door AI gemodelleerde muzikanten richting mijn visie. Of, in de woorden van Sifu Rick Rubin:
Ik geloof oprecht dat deze producersrol de echte toegevoegde waarde van AI laat zien. Als hulpmiddel vormt AI een abstractielaag: je hoeft niet eerst alle fijne kneepjes van orkestrale compositie te beheersen om een eenvoudige discostrijkerslijn uit te werken.
De echte kracht ligt in leren hoe je effectief met de technologie communiceert.
Laten we dit concept daarom doortrekken naar andere toepassingen van taalmodellen. Of het nu om programmeren of e-mails schrijven gaat, leren praten met de machine wordt een cruciale vaardigheid.
Wat de machine ziet:
Om met een machine te kunnen praten, moet je zijn taal leren en op zijn minst een basisbegrip hebben van hoe de technologie werkt.
Een paar woorden uit onze menselijke woordenschat zien er voor een taalmodel ongeveer zo uit:
[7, 1100, 6962, 70238, 873, 659, 8773, 42308, 230, 42300, 35795]
Dit proces, waarin woorden in getallen worden omgezet en vervolgens betekenis en context worden berekend, is door de jaren heen geëvolueerd:
- 2013 - Word2Vec (statische embeddings): Eén vector per woord.
Geen besef op zinsniveau, wat veel contextproblemen oplevert. Elk woord heeft een vector en het model interpreteert de context woord voor woord. - 2018 - BERT (contextuele embeddings): De context wordt nu door de zin bepaald, in twee richtingen. Dit model wordt nog steeds veel gebruikt en biedt veel meer controle en nuance.
- 2020 - GPT-3: Een transformer die op basis van eerdere context het volgende token voorspelt en genereert. Daarvoor gebruikt het positionele codering om vloeiende tekst, en code, te produceren.
- 2025 - AI-agentframeworks: Een opkomende aanpak waarin taalmodellen hulpmiddelen kunnen gebruiken, bronnen kunnen raadplegen en taken in meerdere stappen uitvoeren. En we zijn vertrokken.
Nou ja, bijna. Taalmodellen kunnen er nog steeds een puinhoop van maken. Hallucinaties hebben niet één eenvoudige oorzaak: onvolledige context, ambiguïteit, trainingsdata en de manier waarop het model waarschijnlijk tekst genereert, kunnen allemaal een rol spelen. Ik laat de technische details hier achterwege om dit enigszins kort te houden.
Zonder te diep in de technische details te duiken, zijn dit enkele basisrichtlijnen om in gedachten te houden:
- Verander je uitgangspunt: Stel je geen intelligente entiteit voor. Zie AI als een zeer ingewikkelde cocktailshaker voor data: het systeem bestaat uit statistiek, modellering en software.
- Wanneer het model hallucineert: verander je aanpak. Controleer je bronnen, verduidelijk de opdracht en begin zo nodig met een schone chatcontext. Beheer de invoer zorgvuldig.
- Neem verantwoordelijkheid voor de context: Context beheren en uitleggen is jouw taak. Laat de AI unieke gegevens genereren, maar jij bent degene die stuurt.
Context + best practices:
- Je prompt... neem de tijd om hem te schrijven!!
- Gebruik scheidingstekens. Tekst: """{voer hier tekst in}""" of ###
- Relevante bestanden en voorbeelden (screenshots werken ook)
- Eerdere prompts en antwoorden in hetzelfde gesprek. Werk heen en weer, verfijn je vraag en zoom zo geleidelijk in op het antwoord dat je nodig hebt.
- Sommige modellen reageerden in mijn tests beter op expliciete coaching, bijvoorbeeld: 'Houd je niet in. Geef alles.'
Dat is geen persoonlijkheid of behoefte aan complimenten, maar gedrag dat per modelversie kan veranderen.
- Gebruik positieve beperkingen ('Doe X, neem Y op, respecteer Z') in plaats van 'doe dit niet'.
- Met ChatGPT: gebruik opsommingstekens en tussenkoppen om je eisen te ordenen. Zie je hoe ik mijn prompt voor Suno in secties heb verdeeld?
- Leg bij Google Gemini niet alleen de taak uit, maar ook het doel. In mijn tests leverde die extra context vaak een beter resultaat op. Ook dit kan per modelversie verschillen.
- Gebruik een LLM om prompts voor gevorderden te schrijven. Geef het een voorbeeld van een goed doordachte prompt en laat het die structuur voor nieuwe opdrachten volgen.
- Voer geen vrijblijvend gesprek als je een concreet resultaat nodig hebt. Benoem het gewenste resultaat, de rol en de focus.
Structureer je prompt met een promptframework, bijvoorbeeld:
- RTF: rol, taak, uitvoerformaat
- TAG: task, action, goal (taak, actie, doel)
- CARE: context, action, result, example (context, actie, resultaat, voorbeeld)
- FIRE: focus, input, result, evaluation (focus, invoer, resultaat, evaluatie)
- Voeg als bijlage een instructiebestand aan je prompt toe
- Gebruik AI-agents voor taken die hulpmiddelen of meerdere stappen vereisen, niet voor iedere korte vraag. Bij eenvoudige taken kunnen ze gemakkelijk een konijnenhol induiken. Je kunt gevalideerde prompts ook in afzonderlijke chats na elkaar uitvoeren en zo betere resultaten krijgen.
- Er zijn online veel promptgeneratoren. Sites als https://promptboost.dev/instructions zijn bijvoorbeeld uitstekend voor ontwikkelaarsprompts.
Misschien heb je gehoord van 'redeneermodellen'. Als je een LLM gebruikt en er staat 'langer nadenken' of 'redeneren', dan is dat waar ik het over heb. (Ik heb hierover een blogpost: lees de gekoppelde bron.)
- Gebruik ze als inspiratie bij lastige problemen
- Een redeneermodel besteedt extra rekenwerk aan tussenstappen voordat het antwoord geeft. Die interne verwerking is niet hetzelfde als menselijke gedachtegang en wordt niet altijd zichtbaar gemaakt
- Redeneermodellen schieten vaak voorbij aan een verzoek. Gebruik ze niet voor eenvoudige zaken
- Sommige redeneermodellen en interfaces bieden een instelling voor redeneerinspanning. Daarmee kies je hoeveel rekenwerk het model aan een antwoord mag besteden
- Geef alleen context die relevant is. Een enorme, ongerichte berg achtergrondinformatie kan de opdracht juist minder duidelijk maken
- Ga niet vibe-coden en 'chat' niet met een redeneermodel
Er valt hier veel te verwerken. Bedankt voor het lezen. Ik hoop dat je bij het uitproberen van deze technologie ook een soort 'wauw'-moment beleeft, en veel succes met praten met de machine.
Kai
De kunst is van de fantastische maker: https://superrare.com/grif